NEC WG2600HP用 OpenWrt 25.12.6 NSSオフロード有効版

NSSオフロードを有効にしたQualcomm IPQ806x機種向けのOpenWrt25.12.6ビルドが公開されているのを発見したので、こちらをありがたくベースにさせてもらってNEC WG2600HP用のイメージを仕立てました、というメモ。10年以上前の機体なのでもはや使う人もいないだろうけど、何かの役に立てば幸いです。

※大半の作業をClaudeにお願いして作った個人用の趣味のビルドです。At your own riskでお使いください。WG2600HP2での動作は不明であり、導入は非推奨です。

GitHubリポジトリ

sysupgradeイメージはこちら。

ビルド概要

  • NEC WG2600HP用 OpenWrt 25.12.6。実機で最低限のテスト済み
  • NSSオフロード有効。IPv4/IPv6/PPPoE/DS-Lite/MAP-E等の有線通信がオフロードされ、ほぼCPUを使わずに1Gbpsのワイヤレート上限で処理できる
  • 公開イメージはTailscale入りでサイズが少し大きい。要らない人は自前でビルドし直してください
  • テスト中に見つけた複数のバグに対する個人的フィックスを含む

詳細は以下のReadme日本語訳を参照してください。

Readme日本語訳

NEC Aterm WG2600HP 向けカスタム NSS ビルド

このブランチは、初代 NEC Aterm WG2600HP(IPQ8064)向けの、NSS オフロードに対応した OpenWrt 25.12.6 のビルドです。gyimesibalazs/openwrt-ipq806x-nss-25.12 をベースに、いくつかの修正を加えています。個人で利用するために作ったプライベートビルドです。

  • ベース: gyimesibalazs/openwrt-ipq806x-nss-25.12、ブランチ ipq806x-nss-25.12.6、commit a0d03e3b8b(OpenWrt 25.12.6 r33311、kernel 6.12.112、swconfig、qca-nss-gmac、NSS、ECM)。ベースは、tingalvin/r7800 の NSS 対応を OpenWrt 25.12 に移植したものです。
  • feeds: ベースの feeds.conf.default で固定された commit を、そのまま使います。tailscale 1.104.1 と Go 1.27 は、openwrt-25.12 の packages feed のものです。
  • パッケージ管理: apk(OpenWrt 25.12)。
  • イメージ: このリポジトリの Releases ページにあります。

このリポジトリの GitHub 上の fork 関係(tingalvin/r7800)は、以前の 24.10 版ビルドのものです。24.10 版はすでに削除しました。

ベースからの変更

# 変更 場所
1 qca-nss-ecm: standard プロファイルを起動時に開始し、firewall4 と連携する このブランチの commit
2 qca-nss-ecm: accel_delay_pkts を 1 から 24 に変更 このブランチの commit
3 qca-nss-clients tunipip6: encap の例外処理での dst リークを修正 このブランチの commit
4 qca-nss-ecm: インターフェースの機能を、イメージに組み込まれる kmod の分だけ有効にする このブランチの commit
5 qca-nss-ecm: ECM のロード中は conntrack イベントを有効にする(MAP-E の修正) このブランチの commit
6 イメージ: sysupgrade イメージが収まるかを検査する(24192k) このブランチの commit
7 ベースの GitHub workflow を削除 このブランチの commit
8 NSS 用の、初回起動時の初期設定 custom/files/wg2600hp/etc/uci-defaults/98-wg2600hp-nss-defaults
9 config: WG2600HP のみ、パッケージの選択、CONFIG_ALL_KMODS=y custom/configs/wg2600hp.config
10 トップの README はこの文書を案内する。ベースの README は README.base.md として残す このブランチの commit

ベースの以下の部分は、変更せずに使います。

  • NSS の CPU 分散: qca-nss-drv の init スクリプトが、2 つ目の NSS コアの IRQ を CPU1 に移します。また、qca-nss-drv の packet steering のフックが、汎用の packet steering スクリプトの後で eth* の RPS を 0 にします。
  • kernel、NSS のファームウェアとドライバ、WG2600HP の swconfig 用 device tree。

ベースの以下の部分は使いません。

  • config の元になる diff と diff-c2600(配布名「OpenWrt NSS」、他の機種)。このビルドの config は custom/configs/wg2600hp.config です。
  • VHTNSS.zip(ベースの workflow が feeds に適用する LuCI のパッチ)。

1. ECM の起動と firewall4

  • kmod-qca-nss-ecm-standard が、ファイアウォール用スクリプトで使う iptables-nft と iptables-mod-physdev に依存するようにしました。
  • init スクリプトを rc.common 形式でインストールし、ECM が起動時に開始するようにしました。
  • ファイアウォールの include を fw4_compatible として登録しました。この include は、ファイアウォールが先に起動した場合に備えて ECM を開始し、ファイアウォールの reload 後には加速中の接続を flush します。
  • bridge netfilter の sysctl は /etc/sysctl.d/99-qca-nss-ecm.conf に書くので、既定値の後に適用されます。

2. accel_delay_pkts=24

ECM は、各接続の最初の accel_delay_pkts 個のパケットを CPU で処理し、その後で接続を NSS に渡します。

  • 元の値 1 では、ECM は TCP 以外の接続を、両方向のパケットを見るまで加速しません。このため、DS-Lite、MAP-E、片方向の UDP は CPU で処理されたままでした。
  • 24 にすると、これらはすべて NSS で処理されます。

注意:

  • 1 以外の値では、片方向で見た DSCP と mark が両方向に適用されます。QoS の分類や、mwan3・ポリシールーティングの mark に影響することがあります。
  • 値を変えるには、/etc/init.d/qca-nss-ecm の load_ecm() にある echo 24 > .../accel_delay_pkts の行を編集し、/etc/init.d/qca-nss-ecm restart を実行します。sysupgrade すると 24 に戻ります。

3. tunipip6(DS-Lite/MAP-E)の dst リーク

Qualcomm の upstream の修正(qca-nss-clients ec7a57b)です。nss_tunipip6_encap_exception() で検索した route を解放します。この修正が無いと、該当するパケットごとに dst エントリがリークし、ip_dst_cache が際限なく増えます。130 はこのパッケージの Linux 6.12 用パッチが使っているので、パッチの番号は 140-... にしました。

4. ECM の機能と CONFIG_ALL_KMODS

CONFIG_ALL_KMODS=y は、後から kmod を追加できるように、全 kmod をビルドします。同時に、kmod-sit、kmod-pppol2tp、kmod-macvlan、kmod-ipsec が =m になります。元の Makefile では、このツリーの NSS ドライバに無い機能を有効にして ECM がビルドされ、ビルドが失敗していました。そこで、これらの機能は、イメージに組み込まれる(=y)kmod の分だけ有効にするようにしました。

5. conntrack イベント(MAP-E の修正)

Linux 6.x では、net.netfilter.nf_conntrack_events の既定値が 2 です。この場合、接続ごとのイベント用データは、ctnetlink のリスナー(conntrack -E など)が動いている間しか確保されません。リスナーが無いと、ECM は接続の破棄を知らされず、閉じた接続の NSS ルールが残ります。

MAP-E は送信元ポートを小さなポートセットに割り当てます。このため、LAN 側のアドレスとポートを再利用した新しい接続が古いルールで変換され、通信が止まっていました。

ECM の init スクリプトは、qosmio/nss-packages と同じように、ECM のロード時に nf_conntrack_events を 1 にし、アンロード時に 2 に戻すようにしました。これにより、通信の停止は解消しました。追加で使うメモリは、接続あたり約 16 バイトです。

6. イメージサイズの検査

sysupgrade イメージは、ファームウェアのパーティション(24192k)に収まる必要があります。この検査により、大きすぎるイメージは作られず、ビルドが失敗します。

7. GitHub workflow

ベースには、他の機種のイメージを別の config でビルドし、v* タグで公開する workflow があります。このブランチは custom/build.sh でローカルにビルドするので、workflow は削除しました。

8. 初回起動時の初期設定

初回起動時に、98-wg2600hp-nss-defaults が以下を設定します。

  • ファイアウォールの software / hardware flow offloading を無効にします。これらは NSS のスイッチではありません。software flow offloading を有効にすると、IPv4 と PPPoE の通信が NSS を経由しなくなります。
  • packet steering を無効にします。
  • ECM の加速エンジンを nss にします。

9. config

config の内容は以下のとおりです。

分野 パッケージと設定
機種 ipq806x / generic / NEC WG2600HP
スイッチと Ethernet swconfig、qca-nss-gmac
オフロード qca-nss-drv、qca-nss-ecm-standard、NSS の PPPoE と tunipip6 のクライアント
WAN PPPoE、DS-Lite、MAP-E(map)、odhcp6c
VPN WireGuard(kmod-wireguard、wireguard-tools、luci-proto-wireguard)、tailscale
管理と監視 LuCI、conntrack、collectd、luci-app-statistics、collectd-mod-sensors
無線 QCA99x0 の board data、ath10k-ct
ビルド CONFIG_ALL_KMODS=y、CONFIG_KERNEL_BUILD_USER="builder"、CONFIG_KERNEL_BUILD_DOMAIN="buildhost"

CONFIG_ALL_KMODS=y だけでは、NSS 関連の kmod の一部も選ばれ、イメージに入る NSS ドライバと ECM が変わってしまいます。config ではこれらを無効にしています。対象は、kmod-bonding とそれを選ぶ kmod(kmod-qca-mcs と、もう一方の ECM の variant)、および NSS の追加機能の kmod(crypto、qdisc、L2TP、6rd など)です。これらの NSS の kmod は、後から追加できません。

tailscale

  • イメージには、openwrt-25.12 の packages feed の tailscale 1.104.1(tailscale と tailscaled)が入っています。tailscale のライセンスは BSD-3-Clause です(LICENSE を参照)。このビルドは Tailscale Inc. とは関係がありません。
  • イメージに tailscale のログイン情報や状態は含まれません。tailscaled は起動時に開始しますが、ログインはしていません。ルーター上で tailscale up を実行し、表示される URL でログインしてください。
  • tailscale の版は、イメージのビルド時に決まります。overlay には、ルーター上で更新するだけの空きがありません。tailscale を更新するには、新しい packages feed でイメージを再ビルドし、-n を付けずに sysupgrade を実行します。これで、/etc/config と、/etc/tailscale にある tailscale のログイン情報が引き継がれます。

tailscale なしでビルドする

  1. custom/configs/wg2600hp.config の
    CONFIG_PACKAGE_tailscale=y
    を
    # CONFIG_PACKAGE_tailscale is not set
    に置き換えます。
  2. 次の「ビルド」の手順でビルドします。

Go がまったくビルドされなくなるので、ビルド時間の大半を省けます。イメージもかなり小さくなります。

ビルド

OpenWrt をビルドできるホスト(OpenWrt のビルドシステムの文書を参照)で、以下を実行します。

git clone -b custom/ipq806x-nss-25.12.6 https://github.com/<this repository>.git openwrt
cd openwrt
custom/build.sh wg2600hp -j$(nproc)

custom/build.sh は以下を行います。

  1. 前提条件の検査が英語の出力を解析するので、LC_ALL=C を設定します。
  2. feeds.conf.default の全 feed が commit に固定されていることを確かめ、そこから feeds.conf を作ります。feeds を更新し、チェックアウトされた commit を確かめます。
  3. feeds をインストールします。
  4. custom/files/wg2600hp を files/ として配置します。
  5. config を .config にコピーします。
  6. make defconfig、make download、make を実行します。

イメージは bin/targets/ipq806x/generic/ にできます。Go をソースからビルドするので、時間がかかります。

インストール

この手順は、すでに OpenWrt が動いている WG2600HP が対象です。NEC の純正ファームウェアからの最初のインストール(シリアルコンソールと TFTP)は、OpenWrt wiki の WG2600HP のページを参照してください。

他のビルドから移行するときは、設定を引き継がずにインストール(sysupgrade -n)してください。このリポジトリの以前の 24.10 版ビルドからの移行も同じです。

  • OpenWrt の公式リリースは DSA を、このイメージは swconfig を使うので、ネットワーク設定に互換性がありません。
  • OpenWrt 25.12 は opkg ではなく apk を使います。24.10 版に追加したパッケージは引き継げません。
ssh root@192.168.1.1 'sysupgrade -b /tmp/backup.tar.gz && cat /tmp/backup.tar.gz' > backup-before.tar.gz
cat openwrt-ipq806x-generic-nec_wg2600hp-squashfs-sysupgrade.bin | ssh root@192.168.1.1 'cat > /tmp/fw.bin'
ssh root@192.168.1.1 'sha256sum /tmp/fw.bin; sysupgrade -T /tmp/fw.bin && echo OK'
ssh root@192.168.1.1 'sysupgrade -n /tmp/fw.bin'

その後、ルーターは初期状態で起動します。

  • LAN のアドレスは 192.168.1.1
  • root パスワードは未設定
  • 無線は無効

NSS が働いていることは、以下で確かめられます。

dmesg | grep -E "nss core [01] booted"
lsmod | grep -E "^(ecm|qca_nss_drv|qca_nss_gmac|qca_nss_pppoe|qca_nss_tunipip6) "
cat /sys/kernel/debug/ecm/ecm_classifier_default/accel_delay_pkts    # 24
cat /proc/sys/net/netfilter/nf_conntrack_events                      # 1

注意

  • LuCI で software / hardware flow offloading を有効にしないでください。packet steering も無効のままにしてください。SQM(sqm-scripts)は CPU で動き、NSS を経由しません。
  • 他のパッケージは、公式の 25.12.6 の feeds から追加できます(apk add)。ただし、カーネルモジュール(kmod-*)は例外です。公式のものはこの kernel に合わないので、このブランチを自分でビルドしたもの(bin/targets/ipq806x/generic/packages/)を使ってください。
  • 初回起動後の overlay の空きは、約 6.4 MiB です。

テスト

このイメージは、WG2600HP の実機で動作を確認しました。

  • NSS オフロード: 素の IPv4、PPPoE、IPv6、DS-Lite、MAP-E の TCP と UDP が、CPU がほぼ空いたまま回線速度で流れました。WireGuard は CPU で処理されます(TCP 1 本で約 330〜380 Mbit/s)。
  • これらの WAN 種別での負荷試験: 再起動なし、kernel の警告なし、メモリ使用量の増加なし。
  • Wi-Fi、5 GHz でクライアント 1 台: WPA2-Personal と WPA3-Personal(SAE)のどちらでも、切断なく接続できました。

試験していないもの: 2.4 GHz、Wi-Fi のスループットと到達距離、複数のクライアント、長期間の使用、再起動の繰り返し。

このイメージは WG2600HP の実機で動作を確認しましたが、試験の範囲は限られています。長期間の安定性や、細かな設定変更をした後の正常な動作は確認していません。自己責任で使ってください。

ライセンス

OpenWrt と各パッケージのライセンス(主に GPL-2.0)に従います。このブランチのパッチは、変更したファイルのライセンスに従います。


OpenWrt 25.12でのPacket Steeringとスループットの関係(IPQ4019 / MT7622 / IPQ8072ほか)

マルチコアCPUを載せたデバイス上のLinuxがネットワークトラフィックをどう効率的に分散処理するか?というロジックはリファレンス資料に詳細に解説されているんですが、複雑すぎて良く分からないし、じゃあ実際にはどうなるのよ、ということで手持ちのOpenWrtルーターの挙動を実際に見てみたというメモです。図表は全てClaude君の手によるものです。図表だけではありませんが。

※この記事はCPU振り分けの挙動について書いたものです。各機体のスループットは参考値であり、同一機体内での比較用です。スループット計測結果は別記事にするつもり。

このエントリで取り上げた機種とSoC

  • Qualcomm IPQ4019 (Google Wifi, Netgear RBR50, Linksys WHW03 v2)
  • Marvell Armada 7040 (Check Point V-80)
  • Marvell Armada 385 (FortiGate 50E)
  • MediaTek MT7622B (Linksys E8450, Buffalo WSR-2533DHP2, ELECOM WRC-X3200GST3)
  • Qualcomm IPQ8072A (Linksys MX5300)
  • Qualcomm IPQ8064/8068 (NEC WG2600HP, Meraki MR52)
  • MediaTek MT7621A (ELECOM WRC-1167GST2)

基本的なルール

  • 今どきのルーターはほぼ確実にマルチコアCPUを積んでいて、トラフィック処理を複数のコアに分散できれば性能(≒スループット)が上がり、単一または少数のコアしか使えなければ頭打ちになる(可能性が高くなる)。効果的に使えるかどうかは実装と状況次第。

  • コア割り当ては数多くの要素で最終的に決まる。ロジックは機種ごとに全然違う。通信先のIPアドレスと通信ポート番号、ハードウェアの実装とドライバの挙動、LinuxカーネルのCPU affinity設定、OpenWrtのPacket Steering定義と設定、などである。他にも色々ある。

  • 一般的なTCP/UDPの通信だとフローごとにポートが変わって割り当ても変わるため、タイミングにより処理能力に当たり外れが出て、速度が出たりでなかったりする。また、通信先やポートが同じだと割り当てが変わらず、常時特定のコアに処理が集中し続ける現象が起きる。カプセル化(トンネリング)が入る回線、例えばDS-LiteやMAP-EのIPv4-over-IPv6の下りトラフィックが該当する。

  • OpenWrtのPacket Steeringの設定は、CPU割り当てルール自体を変更するため、どのルールを選ぶかによって結果に大きな影響が出る(出ないこともあるが)。

ここからはClaude君に描いてもらった図を入れて実例を紹介。以降の内容は全てOpenWrt 25.12.5でのもの。

Google Wifi Gale (Qualcomm IPQ4019, 4 core)

IPQ4019はコア数が多いが周波数が700MHzちょっとでコア当たりの性能が低く、その割には動的な処理分散の仕組みを持っていて実験台として最適なので、トップバッターとして登場していただく。ちなみに私は同じSoCのNetgear RBR50とLinksys WHW03 v2も持っているが、完全に同じ挙動だった。

Packet Steering disabled、TCP 1 flow

  • スループットの数字は最も単純なIPv4 NATのみで試した場合。つまり軽い。
  • IPQ4019は4本の受信キューを持ち、着信したフローはハードウェアRSSによりドライバレベルでいずれかのキューに割り当てられる。
  • NAPIがいずれかのCPUコアを選ぶ。ここではPS無効なのでコアは1つだけ選ばれる。図の例ではCPU0だが、フローのハッシュにより別のコアが選ばれるときもある。
  • 戻りのACKはRSS (Receive Side Scaling) で分散できるので別のコアを使える。
  • 処理の大半がCPU0に集中するのでスループットは1コアの性能上限で決まる。この例では482Mbps。

Packet Steering enabled、TCP 1 flow

  • PSが有効だと、NAPIは一部の処理(conntrackやNATなど)をカーネルのRPS (Receive Packet Steering) で別の1コアに分散する。主要な処理に2コアが使えるようになり、2倍まではいかないが処理能力が大幅にアップする。スループットは801Mbpsまで向上する。

Packet Steering disabled、TCP 8 flows

PS無効でTCPの同時接続数を8本に増やした場合。

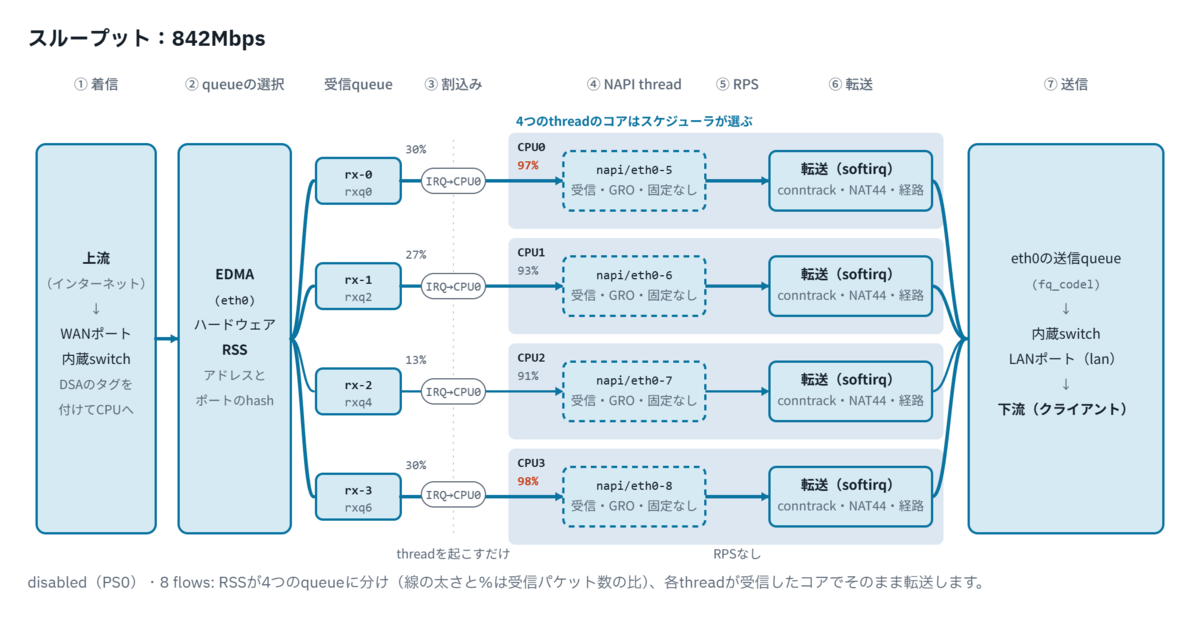
  • PSが無効であってもIPQ4019はハードウェアRSSでフローを分散するので、8本のフローは4本のキューに(概ね)均等に分かれ、4コアで並行処理される。4コアすべての使用率がほぼ100%に近くなる。
  • 全コアを最大限に使っているため、トータルのスループットは842Mbpsに達する。

Packet Steering enabled、TCP 8 flows

  • PS有効でフローが8本来ると、RSSで4コアに分散された後で、さらにNAPIがRPSで2コアに分散する。このRPSでの分散処理が追加のオーバーヘッドとなり、CPUの処理待ちが増えて効率が下がり、PS無効時よりもスループットが下がってしまう。
  • コアのCPU使用率は90%台に乗らず、性能を上限まで出せていない。

まとめと補足

  • 1本のフローでトップスピードが高いのはPS有効だが、同時並行処理数が増えるとPS無効のほうがトータルでは速くなっていく。OpenWrt 25.xの初期値はPS有効。
  • IPQ4019機はマルチコアを効果的に使える作りになっていて、速くはないが極端に遅くもなりづらい。ハードウェアRSSを搭載している機種は結構珍しい。
  • Packet Steeringは設定により有利な場合と不利な場合があり、一概にこの設定が良いとは言えない。初期値のenabledが最もつぶしが効く設定だとは思われるが。
  • 本機ではOpenWrtのPacket Steeringの定義ファイル(packet-steering.uc)にて「受信キューの本数がCPUのコア数以上である場合、"Packet steering=1"と"=2"は同じ処理となる」と定義されている。つまりPS enabledとPS enabled (all CPUs) は同じ結果になる。


さて、無駄に手持ちの他の機種も調べてしまったので、無駄に長いですが一応載せておきます。

Check Point V-80 (Marvell Armada 7040, Cortex-A72 4 Core 1.4 GHz)

比較的新しめの64bit Arm 4コアを搭載するパワフルなデバイスだが非常にクセの強い挙動だった。

Packet Steering disabled、TCP 1 flow ならびに 8 flows

  • 本機(のmvpp2)はIPQ4019のようにドライバでキューごとに4つのコアに処理を割り振るハードウェアRSSを持つ。しかしこのRSS(具体的にはreceive-hashing)が既定でoff(無効)に設定されているため、PS無効状態だと割り振りは発生せず、受信も戻りACKの処理も含めて全てCPU0に集中する。他のコアは一切使われない。
  • なので1コアの性能上限でスループットが上がらない、かと思いきや、基本性能が高いので大半の局面で1コアごり押しでギガビットを捌いてしまう。フローが8本になっても速度は落ちづらい、というかほぼ落ちない。流石本来は10Gbps用にデザインされたSoCである。
  • とはいえDS-Lite/MAP-Eのトンネリングのような重めの処理が入るとCPU0の使用率が100%に達してギリギリになってくる。SQM CAKEでは1コアでは処理しきれなくなり速度が落ちてくる。
  • このmvpp2の挙動(Receive Hash無効)は上流のLinuxからの引継ぎであり、OpenWrt特有の設定ではない。通信に失敗する報告があり安全側に倒した結果のようだが、明らかな理由は不明。

Packet Steering enabled、TCP 1 flow ならびに 8 flows

  • なんとPSが有効でも挙動は変わらず全てCPU0に集中する。PS無効と同じ状態。これが初期設定なので、つまり普通にOpenWrtを入れてデフォのまま使うとNW周りについては1コアしか使わないということになる。
  • PS有効では、キューが入るCPUコアごとに処理を分散する先のコアをもう一つ選ぶのだが、この分散先にも同じCPU0が指定されてしまうため、結果としてPS無効と同じ状態になる。
  • このロジックは超ややこしいので詳細割愛する(多分自分でちゃんと理解できてない)が、おそらく意図されたものではなく結果としてこうなっているように見える。
    • eth0とeth1が同じmvpp2のコントローラに属するので1デバイスと扱われ、割り当てられるCPUも1コアだけ
    • 4本の受信キューがあるのに、NAPIがスレッド化されていないのでキューごとの割り当てが走らず、デバイス全体に1コアが割り当てられる
    • スレッドがないのでPacket Steeringのスクリプトは起動時にイコール条件で4コアのどれかを選ぶことになり、名前順で選ぶので常にCPU0が選択される
  • 繰り返しになるがVPNやSQMを使わない限り1コアだけでギガビットを処理してしまうので、普通に使っていると性能劣化として表面化しづらい。

Packet Steering enabled (all CPUs)、TCP 1 flow

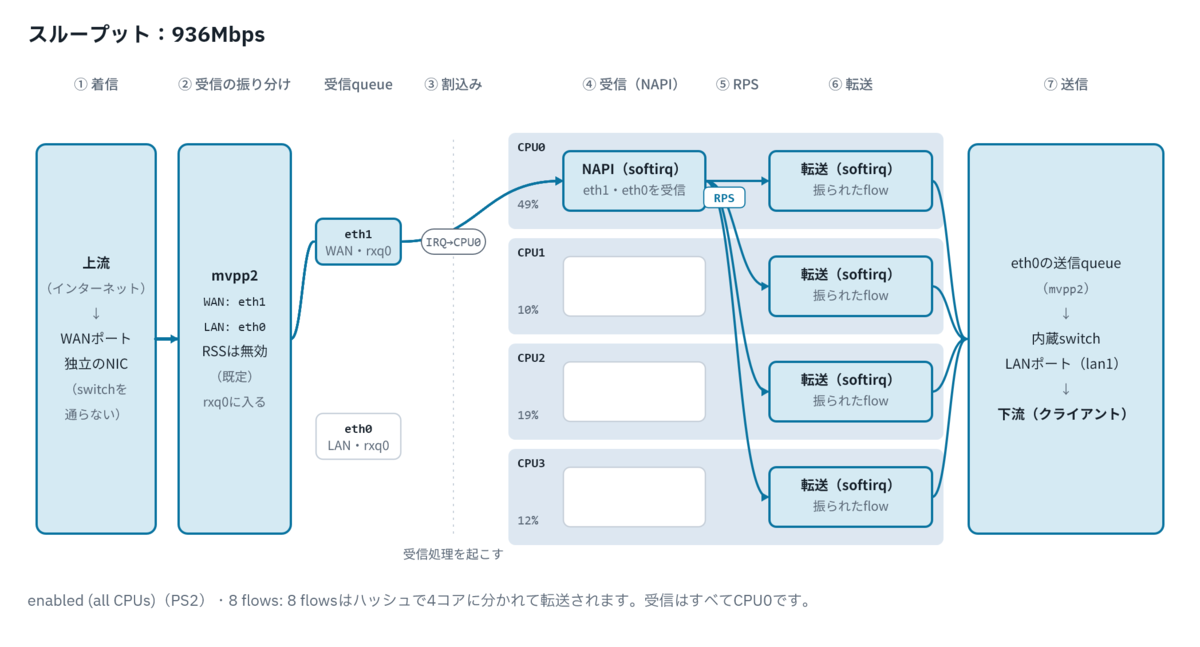
  • PS有効 (all CPUs) を選ぶと、Linuxカーネル側のRPSで処理を4コア全部に分散できるようになる。スループットはワイヤレートのままで変わらないが、内部的には処理が3コア(場合により2コア)に分散してCPU0の負荷は大幅に低くなる。

Packet Steering enabled (all CPUs)、TCP 8 flows

  • 複数フローの同時並行処理ではRPSで全コアに負荷が分散される。相変わらず受信を全て受けることになるCPU0は負荷が高めに出るが、これでマルチコアを最も有効活用できる状態になる。しかしスループットはギガビットの回線上限で変わらないので、やはり普通に使っていると外から見た違いがあまり生じない。というかRPS処理がオーバーヘッドになるので、全体効率としてはむしろ逆効果なのかもしれない。1コアでキャパが足りているなら1コアに任せたほうが効率はいいはずなので。
  • all CPUsが明確に有利になるのはSQM CAKE(のようなデータプレーンが重い処理)を使ったとき。SQMで複数セッションをギガビットのワイヤレートのまま安定して処理できるのはPS enabled (all CPUs) だけ。

追加考察:ハードウェアRSS有効時の挙動

  • RSSは既定で無効だが、設定すれば動かせる。"ethtool -K <eth0またはeth1> rxhash on" でrxhashが有効になり、ハードウェアRSSが稼働して割り当てが4コア全てに分散されるようになる。
  • 分散はフロー単位で1 flowは1コアのままなので、単独フローの処理性能は変わらないが、複数フロー同時並行処理でのトータルの性能が向上する。
  • PS有効と組み合わせると、RSSの後段のPacket steeringが全キューをCPU0に戻してしまうので効果が打ち消された上に、無駄な処理の分CPUを喰って逆効果になる。
  • PS有効 (all CPUs)と組み合わせると1フローをさらに複数コアに分散できて理屈上は単独フローの処理能力は上がるはずなのだが、本機はほとんどの局面でワイヤレートを処理できるので、スループットの数字に違いが表れず効果が確認できない。内部ではCPU使用率が落ちているはずなのだが、これも違いがほとんど見えない。また、SQM CAKEでは内部処理が複雑になりすぎるせいか逆に速度が落ちてしまう。
  • まとめるとハードウェアRSSを有効にすればドライバレベルで負荷を分散できるようになりトータルでは最も効率が良いはずなのだが、実環境ではPS有効 (all CPUs)との有意な違いが見えない。なので、ほぼ同等の効果が得られて設定がシンプルなPS有効 (all CPUs) で使ったほうが話が早くて安全だろうというのが当面の結論。

まとめと補足

  • ツルシ状態でCPU0しか使わなくても十分速いが、とりあえずPacket Steeringをenabled (all CPUs) にしておけばさらに余力ができる。4コアあるのに1コアしか使ってないと思うと何となく気に入らないし(個人の感想です)。ローカルでCPUを喰う別のサービスがゴリゴリ動いているような環境なら競合を避けるために敢えてNW周りはCPU0だけに任せたままにしてもいいけども。
  • WireGuardだと一番重いencryption周りがマルチスレッドで動くので、PSの設定に関係なく4コア全部を使ってワイヤレートを叩き出す。ギガビットでWireGuardやTailscaleを回したいならオススメの機種である。

FortiGate 50E (Marvell Armada 385, Cortex-A9, 2-Core, 1.6GHz)

ロジックはかなり複雑で特徴的だが、2コアしかないので結果はシンプルになる。

Packet Steering disabled、TCP 1 flow ならびに 8 flows

  • 受信キューが8本あるが、フローごとにキューを振り分けるハードウェアハッシュがないので使えない。各ポートで受信したパケットは全て既定のqueue0に入り、CPU0で処理される。PS無効だとそのままCPU0だけの片系運転になる。
  • V-80ほどではないがSoCの地力が高いので、ほとんどの局面で1 flowでも8 flowsでも1コアでワイヤレートを出せる。上の図だと8 flowsではCPU0の使用率が90%台まで上がる。カプセル化が入るとほぼ100%に達するが速度は落ちづらい。
  • 下り(eth0)も上り(eth1)もCPU0に入るので、上下同時にトラフィックを流すと遅くなるかもしれない。

Packet Steering enabled、TCP 1 flow ならびに 8 flows

  • PS有効だとRPSでCPU1に一部の処理が分散する。スループットはワイヤレートのままで変化はないが、内部的にはCPU0に余裕が生まれる。
  • 8 flowsになるとCPU0の使用率が倍の60%台になる。
  • 上りトラフィックはCPU0に残るので、PS無効と変わらない。

Packet Steering enabled (all CPUs)、TCP 1 flow ならびに 8 flows

  • 受信は変わらずCPU0だが、それ以降の処理が2コア両方に分散されて、さらに効率的に処理を分散できるようになる。スループットは相変わらずほぼギガビットを維持するので、外から見ても違いが分からない。
  • 上りも下りも2コアに分かれる。

補足と考察

  • PS有効でも無効でも概ね1Gbpsを捌けるが、重たいSQM CAKEではPS有効が明らかに有利。初期設定のPS有効を敢えて変更するメリットはない。
  • 例外はWireGuardで、PS有効にすると(検証した限りでは)WireGuardの復号処理とRPSで渡された受信処理がCPU1を取り合って遅くなる(630Mbps)。PSを無効にすると処理が分かれて若干速くなる(720Mbps)。
  • WANのブリッジ(br-wan)を解除してeth1を直接使うと上りのCPU使用率が2割から5割程度(相対的に)下がる。ブリッジだとGRO(Generic Receive Offload)でまとめられたパケットをそのまま受けられないので処理前に細かく解いており、その結果処理数が増えているのが原因らしい。この機種はデフォルトでWANの2ポートがブリッジでまとめられているが、マルチWANをしていないのなら解除してもいいかもしれない。デフォで十分速いけど。

まとめ

  • 比較的世代が古い32-bit Armだが全体的に安定して速い。どのPSオプションを選んでもほとんどの局面で1Gbpsの回線上限を出せる。初期設定のPS有効をそのまま使えばいいように思われる。
  • WireGuard/Tailscaleでの性能を重視するならPS無効がよい。

Linksys E8450 (MediaTek MT7622B, Cortex-A53, 2-Core, 1.35GHz)

同じSoCを搭載するBuffalo WSR-2533DHP2やELECOM WRC-X3200GST3でもほぼ同じ挙動と性能になる。

Packet Steering disabled、TCP 1 flow ならびに 8 flows

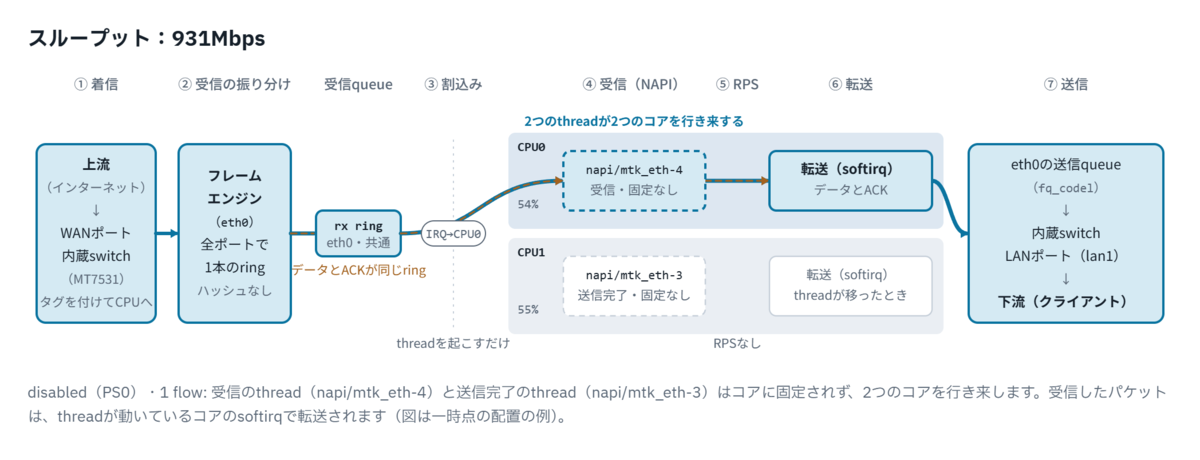
  • 全ポートで1本のringを共有し、RSSはない。全てCPU0からNAPIに渡される。
  • NAPIスレッドが受信用と送信完了用の2本あり、PS無効であるにも関わらず処理中に動的に2コアを行き来するのが特徴的。なので上図では1コアしか使っていないように見えるが、実際にはスレッドがコア間を移動するので両方のコアが交互に稼働している。送信完了処理が別スレッドに分かれるがそれほど重い処理ではないので、トータルでは1フローで1.1~1.4コア分くらいのの処理能力になる。
  • 8 flowsになると実質的に2コアで各4本ずつを捌く状態になる。

Packet Steering enabled、TCP 1 flow ならびに 8 flows

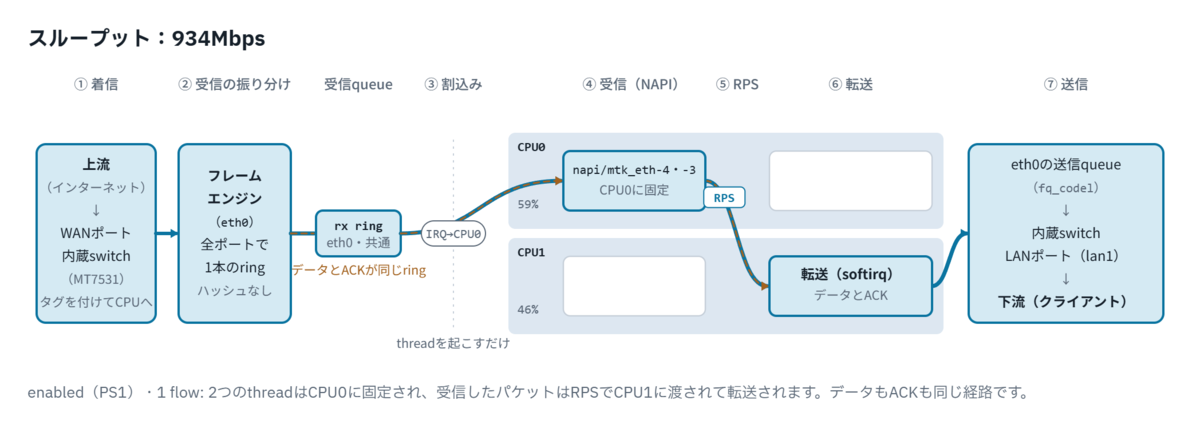
  • PS有効だと2つのスレッドがCPU0に固定され、RPSでCPU1に渡される。経路は一本になるが、処理をほぼ半分ずつ2コアで分け合う。
  • 8 flowsでも経路は変わらないが、softirqを受け持つCPU1の負荷が上がる。しかしキャパシティ上限には達しないので、スループットはワイヤレートを維持できる。

Packet Steering enabled (all CPUs)、TCP 1 flow ならびに 8 flows

  • NAPIはCPU0固定のまま、後段の処理が2コアのどちらかに振られる。CPU0に振られた場合はNAPIと同じコアを使うので、構造的にCPU0の負荷が重くなる。

考察とまとめ

  • 基本的に初期設定のままPS有効で使うのがベター。SoCの基礎性能が高い(FortiGate 50Eとほぼ同等)こともあり、1Gbps回線ではほとんどの場合にワイヤレートを維持できるのだが、SQM CAKEのようなCPUを使い切る重い処理が入って上限を維持できなくなってきたときに、PS無効よりも明らかに有利になる。
  • またPS無効では、処理が重くなると(特に同時並行フロー数が増えてくると)CPUを使い切っていないのに速度が落ちてくる。スレッド移動がオーバーヘッドになって処理待ちが起きているっぽい。なので敢えて選ぶ理由はない。
  • PS有効 (all CPUs) はほとんどの場合にPS有効と同等の性能だが、並行処理数が増えるとCPU0が詰まる。
  • ちなみにWireGuardでは2コアをフルに使い切って600~700Mbps程度出る。同一SoCを積んだWSR-2533DHP2は中古価格がかなり安いので、WireGuardでの価格性能比はめっちゃ高い。
  • 本機は公式OpenWrtでHardware flow offloadingが使える。有効にすると多くの場合にCPUを全く使わずにワイヤレートが出せて、あれこれ言う必要がなくなり、前述の考察はほとんど気にしなくてよくなる。
  • いずれにしても本機は初期設定(PS有効)+HWオフロード有効で使っておけばOKだろう。MT7622はオフロードの大きなバグも出ていない感じだし。オフロードの注意点は、DS-Lite/MAP-Eの下りのカプセル(IPv4-over-IPv6)はオフロードに載らないのと、SQMと競合する(SQM処理がすっ飛ばされる)あたり。

Linksys MX5300 (Qualcomm IPQ8072A, Cortex-A53, 4-Core, 2.2GHz)

SoCは2.5Gbpsをサポートしているがデバイス側の実装は1Gbpsポートなトライバンドルーター。特徴はPacket Steeringの設定に関わらず(有線の)あらゆる受信割込みがCPU3に設定されていることと、RPS(Packet Steering)でEthernetポートごとに固定のCPUコアが割り当てられること。

Packet Steering disabled、TCP 1 flow ならびに 8 flows

  • PS無効だと全部CPU3に行く。SoCの性能が高いため、フローが1本でも8本でも1コアだけでワイヤレートを維持する。1 flowの時点ですでにCPU3の使用率は100%に達していて余力がないように見えるのだが、8 flowsになっても100%のまま速度が落ちない。内部処理をまとめるなどして耐えているっぽいが詳細未調査。

Packet Steering enbled、TCP 1 flow ならびに 8 flows

  • PS有効では、受信割込みはCPU3のまま変わらないが、その先がRPSで別コアに振り向けられる。戻りのACKも分散する。CPU3の負担は若干下がる。
  • ここでの注目点は、wanとlanのポートごとにRPSの行先コアが決められていること。つまりどのポートにEthernetケーブルを挿すかによってRPSが指定するCPUコアが決まる。上図の測定時は、wanとlan3を使っているので、wan(下り受信)がCPU0、lan3(戻りACK)がCPU1に行く。例えばここでlan3ではなくlan1にケーブルを挿すと、wanとlan1で両方CPU0を使うことになり処理がカチ合うことになる。使うポート番号によって挙動に違いが出るというのは想定外の結果。
  • とはいえ例によってSoCの性能が高いので、割り当てがどうなっていようが大抵の場合は回線上限を維持できる(笑)。

Packet Steering enabled (all CPUs)、TCP 1 flow ならびに 8 flows

  • PS有効 (all CPUs) ではRPSが4コア全てを選べるようになる。しかし振り分けられる後段処理は比較的軽いため、相変わらずCPU3が飽和気味になる。
  • 軽い処理だと違いが分からないが、データプレーンの処理が重い(SQM CAKEなど)場合にはこの設定が最も高い性能を発揮する。

考察とまとめ

  • 受信が問答無用で全部CPU3だったり、繋ぐポートで割り当てが変わるなどの特徴的な挙動を見せるデバイスだが、基礎性能が高いのでツルシで使っておけば実際は特に困らないパターン。4本アンテナのWi-Fiアダプタを3系統積んだトライバンドルーターであり、インターネットゲートウェイとWi-Fiメッシュとアクセスポイントの3役を同時にこなすことを想定してデザインされている(はず)なので、有線周りの処理は意図的にCPU3に寄せて無線とカブりづらくしてあるのだろう。実際Wi-Fiの割込みはsmp_affinityでCPU0~3の全てに分散する設定になっている。実環境で本当に分散されるのかは試していませんが。
  • 細かいことを言うとlanポートは2番か4番を選ぶべき。lan1は避けるべし。
  • 他の機種と同じくWireGuardでは4コアフル稼働でほぼ回線上限速度を出せる。
  • NSSオフロード有効なビルドを使うとほぼ全てがNSSに載るので、上記の考察は気にしなくてよくなる。現時点(2026/10)ではコミュニティビルドか自前ビルドが必要だが、有線周りのオフロードは最近OpenWrtの公式ツリーにマージされたそうなので、もう少しすれば(有線部分は)公式にも来るものと思われる。

NEC WG2600HP (Qualcomm IPQ8064, Krait, 2-Core, 1.4GHz)

さすがに古いこともあり、2コアをフル活用すればギガビットをギリギリ出せるかどうかという性能。であるがゆえにCPU割り当ての重要性を理解するにはとてもいい題材。

Packet Steering disabled、TCP 1 flow ならびに 8 flows

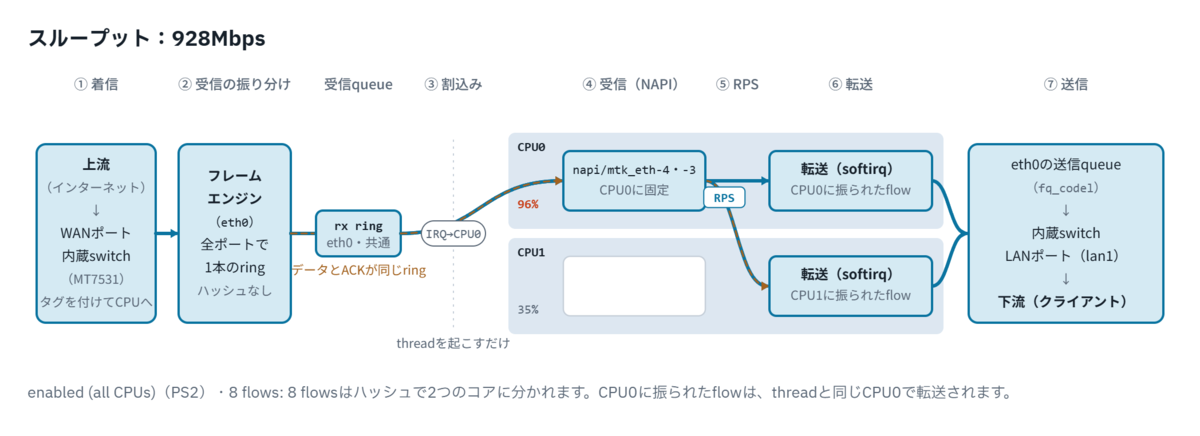
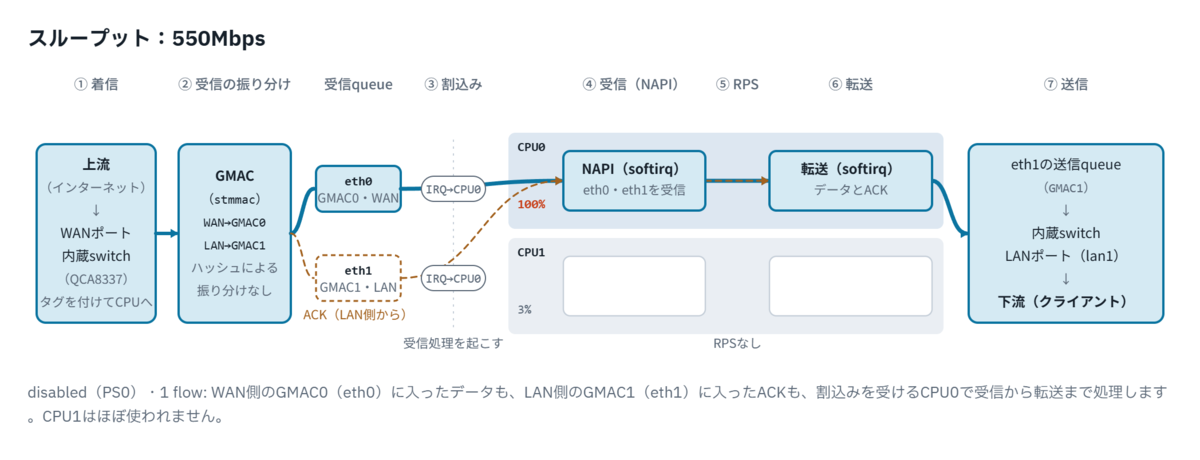
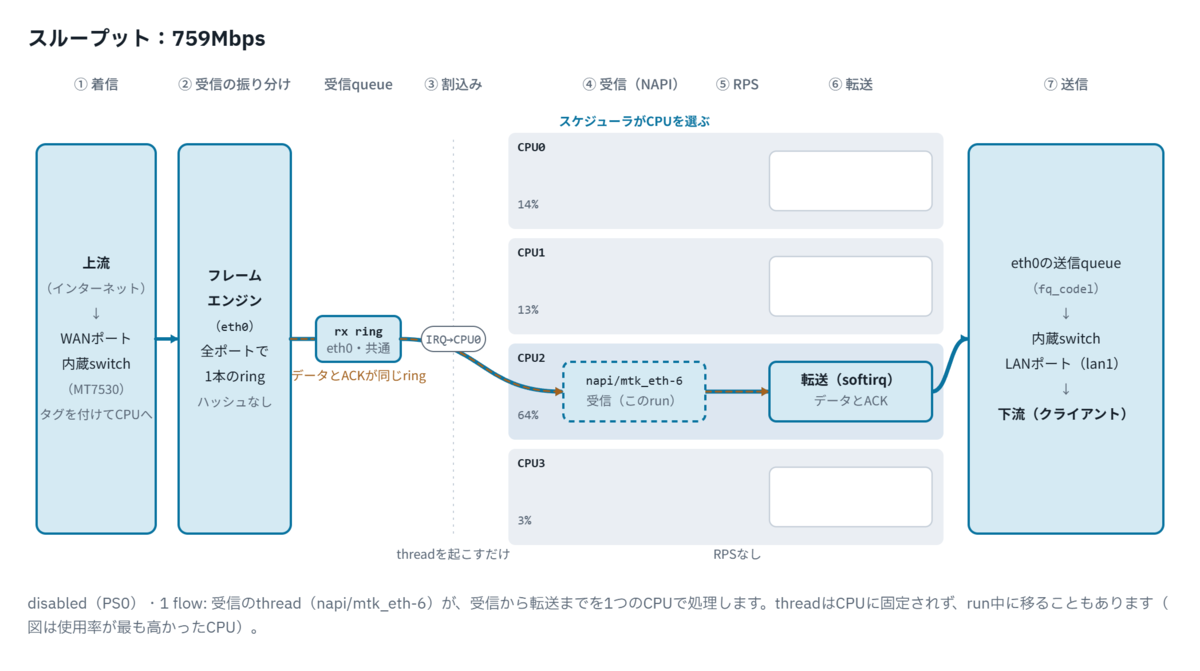
  • PS無効だと、受信割込みを受けるCPU0が最初から最後まで処理を受け持つ。1コアだと性能が足りず、シンプルな1 flowのNATでも1Gbpsの回線速度には達しない。8本になるとさらに処理能力が足りないので、スループットもさらに低下する。

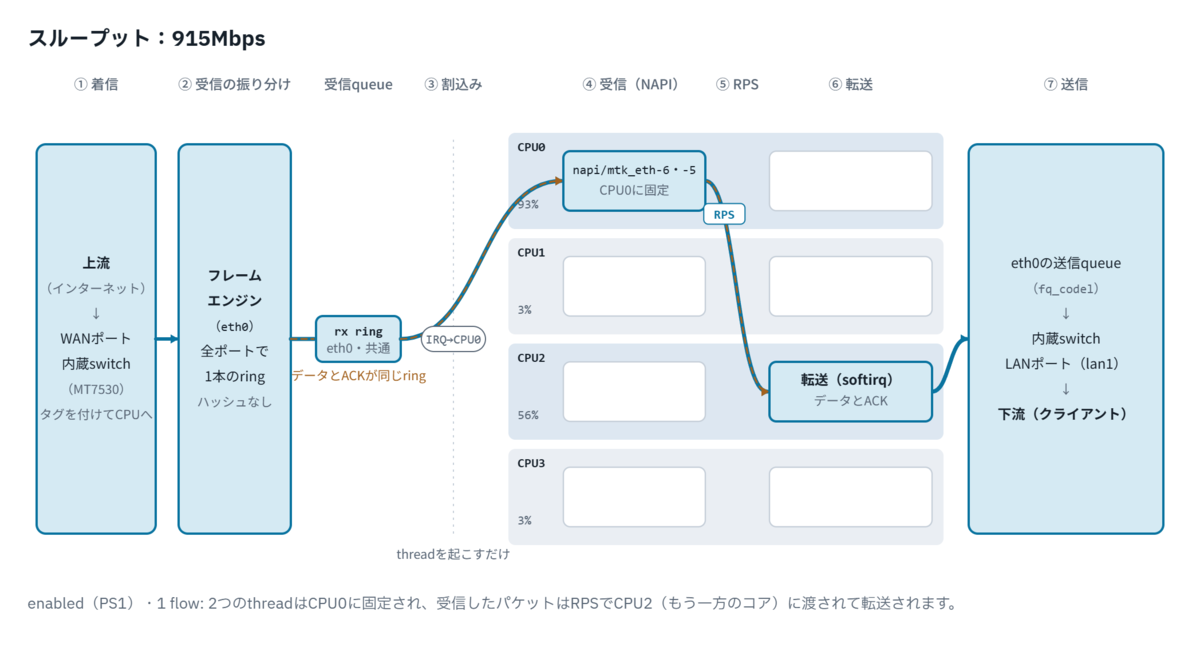
Packet Steering enabled、TCP 1 flow ならびに 8 flows

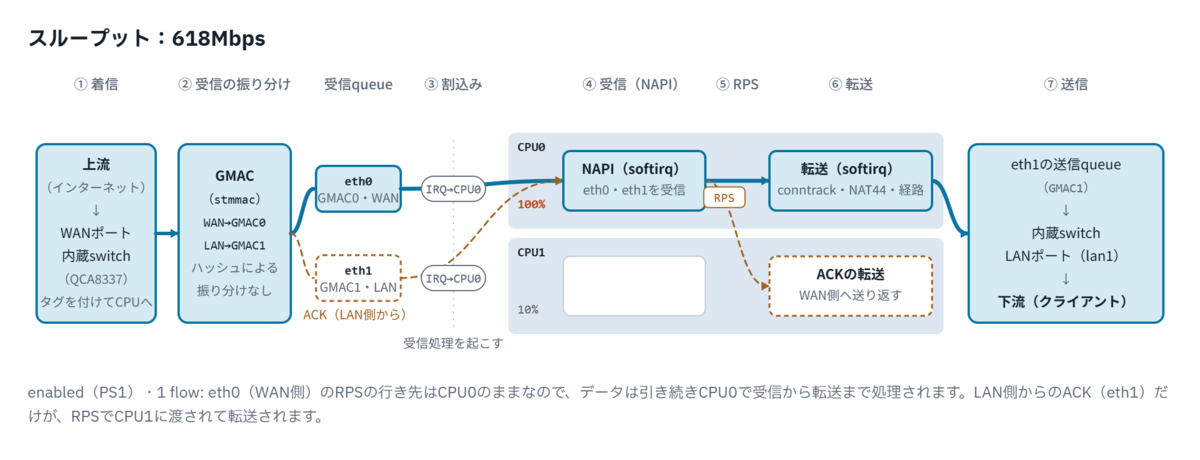
  • PS有効にしてもWANのRPSの割り振り先がCPU0なので大半の処理は相変わらずCPU0が担当する。しかしLANからのACKの戻りがCPU1に分散できるため、PS無効よりも僅かにスループットが向上する。1本でも8本でも経路は同じ。

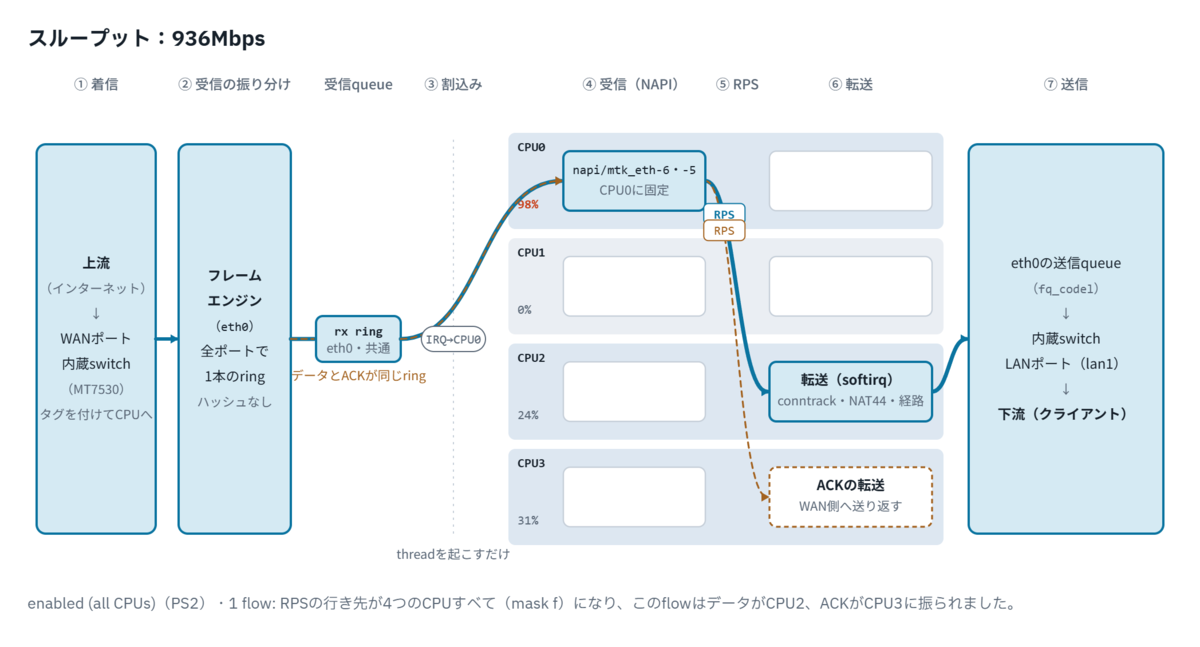
Packet Steering enabled (all CPUs)、TCP 1 flow

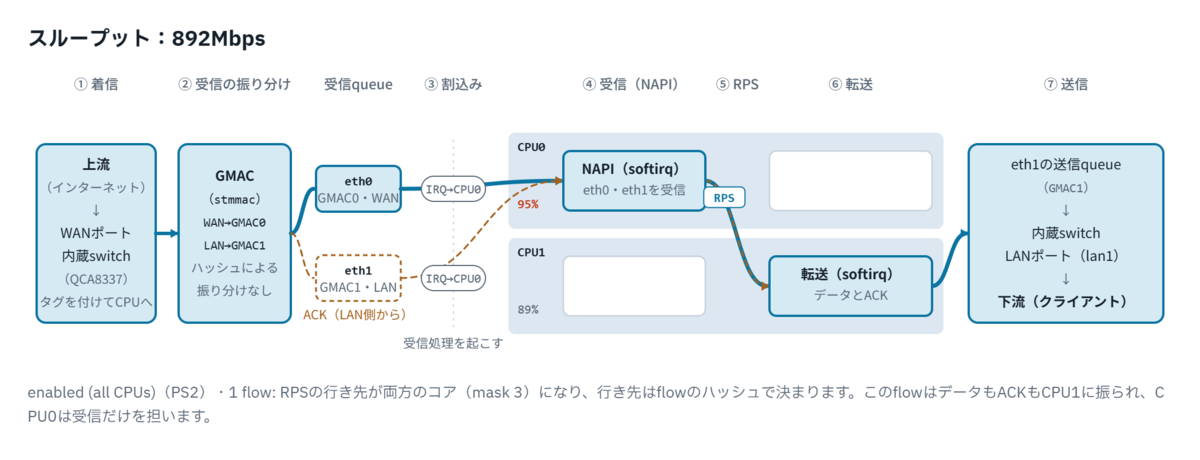
  • ハッシュによってRPSが2コアの両方にフローを振れるようになるので、上図のように2コアに分散すればワイヤスピードに近いスループットを出せる。しかしハッシュによる分散なので、半分くらいの確率でCPU0に向いてしまい片方のコアしか使えなくなる。つまりこの状態だとタイミングによって速かったり遅かったりする。

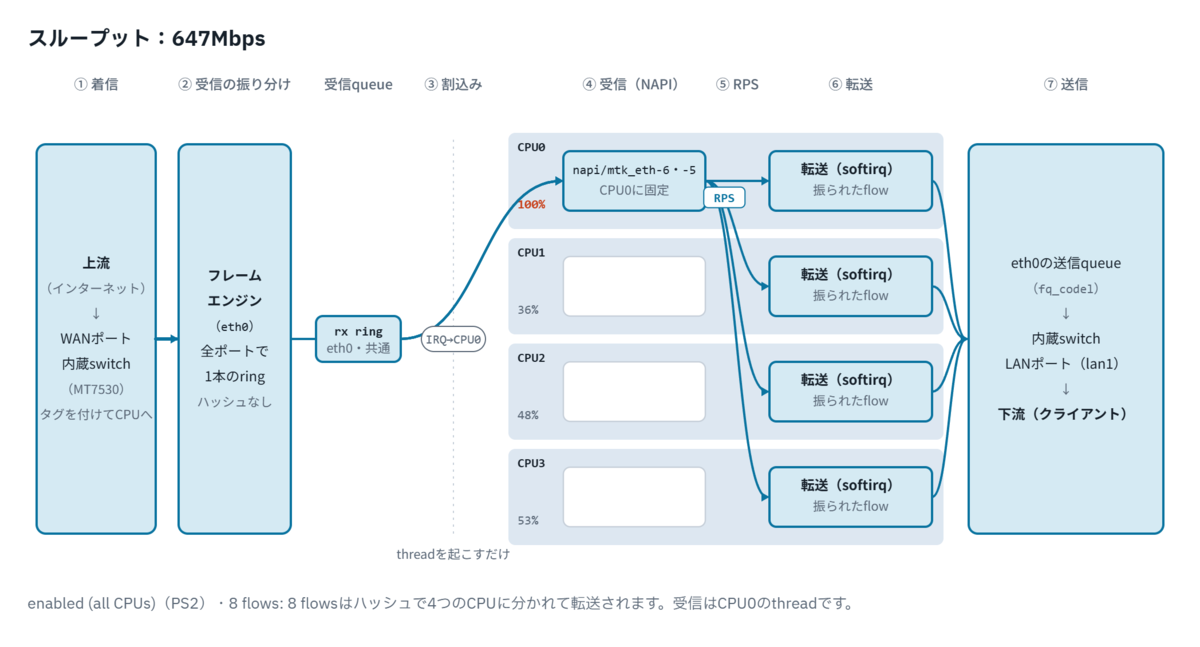
Packet Steering enabled (all CPUs)、TCP 8 flows

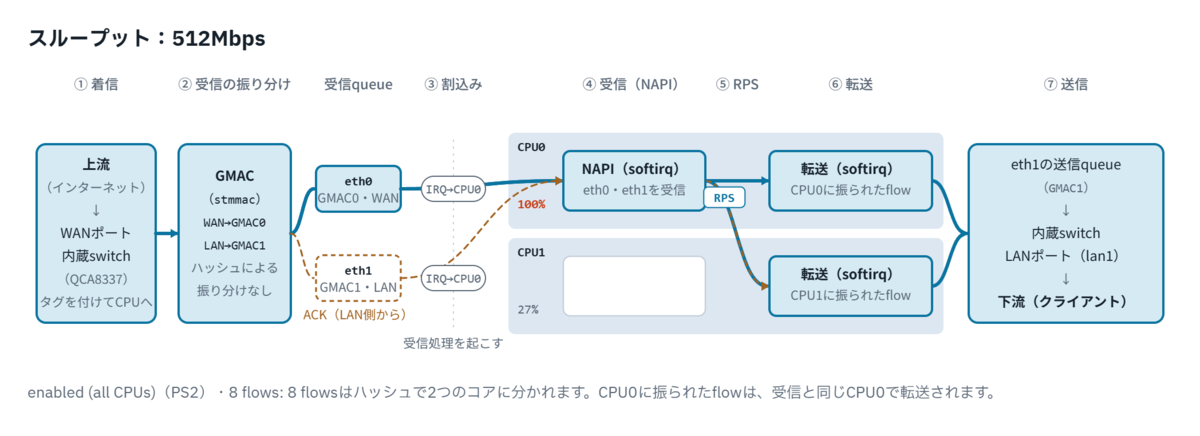
  • 8本同時処理になるとCPU0が詰まり、さらにRPSの処理自体がオーバーヘッドになってCPU1を使い切れない。結果として全体のスループットは落ちる。

本機の(面白い)特性

  • 本機はPS無効だと常に片系しか使えなくなるので、これを選ぶ局面はない。PS有効 (all CPUs)は当たれば速いが外すと遅いので一貫性に欠ける。なので結果にブレが少なくPS無効よりもマシな、初期設定のPS有効をそのまま使うのがベターチョイスになる
  • のだが、PS有効においては「受信割込みは常にCPU0、wanがCPU0、lanがCPU1」になるので、つまり上りは2コアが使えて速いが下りは1コアしか使えず遅いということになる、というか実測でもそうなった。参考までに、同系列SoCでeth0とeth1の割当てが逆になっているMeraki MR52では結果も逆になり、下りが速く上りが遅い。
  • 対策としては、
    • 主に下りトラフィックが速ければいい場合はwan/lanへのeth0/eth1の割当てを交換する。
    • CPU affinityを変えれば上下とも2コアに分散できて均等に速くなる。具体的には "echo 2 > /proc/irq/<eth0の番号>/smp_affinity"を実行する。永続化するには、多分スクリプト化してhotplug.dに登録しないといけないはず(試してないです)。

まとめ

  • 計測の度に速度が変わる現象を典型的に再現できる良デバイス(?)。古すぎるのでもうこの機種を使う人もいないだろうが、勉強になりました。

ELECOM WRC-1167GST2 (MediaTek MT7621A, 1004KC, 2-Core/4-Thread, 880MHz)

古い機種第2弾。Wi-Fi 5時代のボリュームゾーンの定番MT7621。ルーターとしては珍しく2コア4スレッド。

Packet Steering disabled、TCP 1 flow ならびに 8 flows

  • MT7622と同様にNAPIスレッドが処理中にコア間を移動する。スレッドは1本で、一度に使えるCPUは1つだけなので、処理能力は1CPU以上にはならない。4CPU全てで使用率が上がり全部が仕事をしているように見えるが同時には動いていない。
  • フローが複数になっても同様に1つのCPUだけで処理するので、8本流すとスループットは半分以下に落ちてしまう。

Packet Steering enabled、TCP 1 flow ならびに 8 flows

  • NAPIスレッドが2本に増えるが両方ともCPU0に固定され、RPSでパケットがCPU2に渡されて処理される。処理が2つの物理コアに分かれるので1 flowは回線上限に近いところまで速くなる。
  • 同時並行処理数が増えても割り当てはこのままなので、8本流すとCPU2が詰まって速度は大きく(400Mbps以下)落ちる。

Packet Steering enabled (all CPUs)、TCP 1 flow

  • 2本のスレッドがCPU0に固定されるのはPS有効と同じだが、RPSが(ハッシュ次第で)4つのCPU全てに振り分けられるようになる。上図では受信データはCPU2に、戻りのACKはCPU3に分散する。スループットはほぼ回線上限に達するが、RPSを捌くCPU0は余裕がない。なお、CPU2とCPU3は同一物理コア上にあるので、この例では2つの物理コアに処理が最も効果的に分かれている。ハッシュによってはRPSがCPU0とCPU1を選んでしまうこともあり得るので、そうなるとPS無効時よりも低いスループットになる。当たり外れの差が大きい。

Packet Steering enabled (all CPUs)、TCP 8 flows

  • 8本同時処理ではRPSで全部のCPUが使われるが、大忙しのCPU0が詰まってしまうのでトータルスループットは下がる。それでも、転送を1つのCPUに任せるPS有効よりはかなり速くなる。フローの数が多いと当たり外れが薄まるので、パフォーマンスは(見た目上)安定する。

考察とまとめ

  • SoCの(コアあたりの)基本性能が低く、さらに2コア4スレッドという特性が合わさって、非常に一貫性の低いパフォーマンスを示す。少し条件を変えただけでスループットが大きく上下する(場合がある)。ピーキーすぎてお前にゃ無理だよ状態。
  • オフロードが無効だとPS有効(all CPUs)が全体的に強いのだが、このSoCはSoftware flow offloadingが異様に効くという特徴があり、特にSoftware offload+PS有効のときにスループットが激しくブーストされてall CPUsとの力関係が逆転する。同一物理コア上の2個の仮想CPUがキャッシュを共有するからなのかもしれないが謎。さらにHardware Flow Offloadingも使えるので、そうするとオフロード対象はCPUを使わず余裕でワイヤスピード、オフロードに載らないフローはいきなり遅い、みたいな挙動を示す。個人的にはとても面白いけども。
  • まとめとしては、基本的にはHardware flow offloading(問題があればSoftware)をオンにしてPS有効で使えば、なんだかんだで1Gbps環境では概ねルーティングできる。ここにWi-Fiクライアントが接続してくると結構厳しくなりそうだが、まあこのSoCも古いのでもう使う人もいないでしょう。

余談:個人的な面白ポイント

  • 上りと下りで性能が違う機種がある
  • どのLANポートにケーブルを挿すかによってCPU割り当てが変わる機種がある
  • DS-Lite/MAP-Eの下りトラフィックでCPU割り当てが固定されて分散しないため性能が落ちることがある。CPU割り当ては多くの場合フローの発信元/宛先IPアドレスとポート番号を含むtupleから生成したハッシュを使って分散する。のだがDS-Lite/MAP-Eの下りトラフィックはIPv6でカプセル化されてルーターに届くので、外側から見えるのはIPv6の発信元IPのみで、ポート番号は存在しない。さらに実環境でルーターが通信する先はほぼ固定されたプロバイダのAFTR/BRなので、結果としてハッシュは常に同じになり、全ての下りIPv4-over-IPv6通信が常時特定のCPUで処理され続ける展開になる。IPv6ネイティブは引っ掛からないこともあり、普通に使っていると多分気付かない。
  • RPS(カーネルのPacket Steering)は基本的に内側まで見るが、RSS(ドライバ)だと外側しか見ない例があった(IPQ4019とか)。でもmvpp2は内側も見てるようだし、RPSでも外側しか見ない場合(flow label付IPv6やWireGuardのUDPカプセル等)もあるので、一概には言えない。ややこしい。
  • MT7622/MT7621のHardware flow offloadingでは、DS-Lite/MAP-Eの下りIPv4-over-IPv6のカプセル化されたトラフィックは対象外で、ソフトウェア処理される。
  • 特定の機種と用途に絞れば最適な設定は出せなくはないが、どんな場面でも通用する汎用的に優れた設定というのは多分存在しない。あちらを立てればこちらが立たぬ的な感じ。LuCIのPacket Steeringの項目に書いてある"May help or hinder network speed"の意味がようやく分かった感じ。


ということで非常にニッチな話でした。皆さんよいOpenWrtライフを。

某社5Gルーター(第6世代)と一通り格闘してみた

某社のターミナル6に関して、「中のOpenWrtにアクセスできた」という情報を見かけたので、私もネタとして入手して(概ねAIエージェントにお願いして)触ってみました。で、試したことなどをメモ。

個人的結論

  • OpenWrtベースではあるが、実際にはカスタムされた別物のベンダーOSである。カスタムOSなので、シェルに入れても自由度は高くない。やれることは限られる。
  • 弄るにしても、他社simでモバイル回線ルーターとして使うとか、DHCPを止めて単体Wi-Fiアクセスポイント化するか、あたりの「少数の制限を解除した上で、ほぼ標準状態で使う」形に着地する感じ。
  • 公式にOpenWrtに対応すればかなりのナイスデバイスだが見込み薄な感じがする。ソースコードが(完全ではないが)開示されたっぽいので、もしかしたら今後いけるかも。

OSはOpenWrt風の別の何か

  • このデバイスのOSはOpenWrtベースではあるが、ベンダーがForkしてカスタムしてかなりの部分を独自環境化しており、内部的にはKNOSという名前がついている。「OpenWrt21.02.7 を土台に、KNOSというベンダー製管理層・設定生成層・Web UI・FOTA・A/B update機構を載せた派生OS」のように表現できそうである。
  • モジュールはQuectel wirelss networks社のRG620T(MediaTek MT6990/T830)ベースのようである。T830は、5Gモデム+ルーターCPU+高速パケット処理エンジンを一体化した通信装置向けSoC。このSoCはオフィシャルのOpenWrtではサポートされていない。ソースコードも(2026年8月時点で)公開されていない。
  • ネットワーク設定を変更して本機のLANポートからインターネットに出られるようにして、feedをaarch64_cortex-a53へ向ければ、公式のパッケージ群をある程度はopkgでインストールできるようになる。しかしやっぱりカスタムOSなので公式の御作法に則っていないところがあり、例えば、libcパッケージがrootfsには存在しているが/user/lib/opkg/statusには入っておらずopkg時に依存関係でfailするので、ここで手動でステータスエントリにinstalledを追記して突破する、みたいな小修正を繰り返していくことになる。AIエージェントに任せれば概ねやってくれるのだが、毎度試行錯誤にはなる。あとあんまり試していないが、ドライバ依存系のパッケージは利用が大きく制限される(動かない)ものと思われる。
  • 標準的なOpenWrtルーターのブート方式ではない。eMMC上のAndroid boot image形式で、boot_a/rootfs_aとboot_b/rootfs_bのA/B構成である。ブートローダやslot管理も独自で、miscパーティションのbootctrl情報、lk_a/lk_b、tee_a/tee_bなどを前提にしている。
  • Wi-Fiが標準OpenWrtのmac80211/mt76管理ではない。MediaTek独自のmt_wifi、mtkwifi、DATファイル、wapp/mapdで動いている。なのでLuCI/uci/netifdの標準Wi-Fi管理と整合しない。/etc/config/wirelessに標準的な wifi-ifaceがなく、KNOS/MediaTek 独自設定から生成されている。
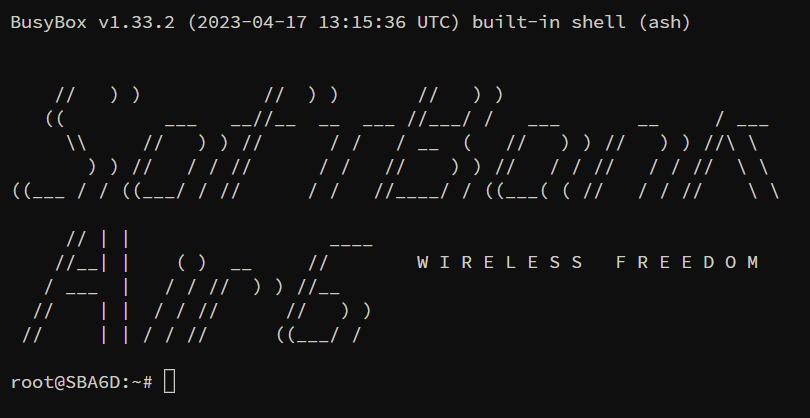
  • SSHでシェルに入ると本家よろしくバナーに"W I R E L E S S   F R E E D O M"と表示されるが、全然自由ではない。なかなかのユーモアのセンスである。

  • GPLの開示義務に沿って有志がソフトバンクやQuectel社にソースコード開示を依頼している事例がWeb上で確認できたが、今のところ開示される兆候はない。
    → こちらのGitHubリポジトリにベンダーから開示されたと思しきソースが公開されている。リポジトリオーナーが「色々足りない」とXでコメントしていたとおり、Wi-Fiドライバなど欠けている点があるが、移植の可能性が上がったとは言えそう。公式開示ではないのでライセンス周りなどの扱いはグレー。

ハードウェアスペック

5G/LTE系は使わないので割愛。

ボード名 MediaTek evb6990_cpe_mt7990_emmc
OS OpenWrt 21.02.7 ベース / KNOS 1.00.24
カーネル Linux 5.4.238 aarch64
統合SoC MT6990 (Arm Cortex-A55 相当 4コア, 最大クロック2.2GHz)
アーキテクチャ aarch64_cortex-a55_neon-vfpv4
RAM 1.76GB
ストレージ eMMC 4GB (実効3.8 GB)
Ethernetスイッチ MediaTek MT7531AE (2ポート 1Gbps)
Wi-Fi Radio

MediaTek MT7990

Radio0 : 2.4GHz (g/n/ax/be) 4x4

Radio1 : 5GHz (n/ac/ax/be) 4x4

Radio2 : 6GHz (n/ac/ax/be) 4x4

USB USB 3.1 Gen2 (1ポート)
電源アダプタ

EIAJ-4 (5.5 × 3.3 mm、center pin 1.0 mm) 12V
# 古いNEC Aterm系列で使われているタイプ

やったこと

中に入ってAP化する

  • まずはLANポートにケーブルを挿しておまじないを唱え、iptablesを落とすかポートを空けるかした上でtelnetdを上げてrootでこんにちわ。後はなんなりと。SSH(dropbear)を常駐化したほうが使いやすいと思う。認証不要なので、呪文をスクリプト化しておけば初期状態のデバイスをLANポートにつないで起動するだけでこんにちわ可能。しかし今どきこの手の典型的な穴がいともたやすくスルーされるのは何故なのか。雑な要件を短納期で安く下請けに丸投げしてラフにリリースしておりセキュリティ品質を保持する責任の所在が企業内で宙に浮いているせいなのか? 石橋を叩きすぎて守りは固いが高コストで牛歩な体質の某競合とは対照的である。知らんけど。閑話休題。
  • LAN向けのDHCPを止める(/etc/config/dhcpのdhcp.lan.ignoreを1に設定するか、dnsmasqとodhcpdをdisableにする)。
  • LuCIを動かす。初期状態ではLuCIは入っていない。起動していないのではなく、主要パッケージが存在していない未導入状態。遠い昔かつてここにはLuCIが存在していました、という名残の設定ファイル等が散発的に残っているだけ。本家の21.0系列から足りないipk群を見繕ってローカルインストールすると一応ログインできるようになり、OpenWrtっぽい見栄えになる。しかしOS内部がOpenWrt標準実装ではないので、LuCIと連携しない機能が多数。特にWireless周りのページは情報が正しく表示されないし、設定変更もできないし、完全体のLuCIではない。
  • アクセスポイント化するにあたって、無線周りの設定を変えるたびにCUIを触るのは面倒なので、ジェバンニCodexに仕様を調べてもらい、LuCI配下にWireless設定用カスタムページの新規増設をお願いしたところ一晩というか15分でやってくれました。SNSで標準LuCIっぽい画面からWireless管理ができてるらしい事例も見かけたが、私はやり方を見つけられなかった。
  • 最終的に各アダプタ上にSSIDを自由に設定してアクセスポイントを立てられるようにはできた。Wi-Fi 7は3系統のWi-Fiアダプタそれぞれで個別に吹ける。5GHz帯での160MHz幅、6GHz帯での320MHz幅も動作した。家庭の単体APとしてこのような広い幅を使う実益があるのかどうかは微妙だが...
  • radio1(5GHz)は起動時やチャネル変更時に必ず一度36chに移動して、一定時間経過後に設定されたチャネルに移動する挙動を示す。DFSを想定してドライバに組み込まれた実装っぽい。

 Wi-Fiバックホール化の試みは全部失敗

  • 我が家にはWi-Fi 7はおろか6Eをしゃべるクライアントデバイスも少なく、さらに上流が1Gbpsなので、このデバイスを単体アクセスポイントとして使っても意味はない。本命は2台対向させての無線バックホール化である。しかしこの試みは上手くいかなかった。
  • まずサテライトとして既存の802.11sのOpenWrtメッシュに参加させようとしたが、ドライバがmesh point非対応なので無理だった。ソースコード非公開なので自力ビルドもできないし。
  • 次にEasyMeshで挑戦。Wi-Fi 7のMLOで超高速バックボーン化というロマン砲は失敗。Controller側は3バンドフルのMLOで起動できるのだが、Agent側がどうやっても3バンドでリンクできず。まあこのようなリンクアグリゲーション風の接続はそもそもEasyMeshでサポートされていないようなので、これは想定どおり。その後6GHzの160MHz幅でリンク成立するところまでは成功した... のだが、デバイス再起動後に6GHzでも5GHzでもAgent側がリンクしなくなってしまった。何故か2.4GHzだけ成功する。解せぬ。結構頑張った(Codexに頑張ってもらった)が設定固定方法が見つからず、それ以上追い込む気力とバジェットがなくなったのでEasyMeshはここで諦めた。知識と根気があればここは突破できそうな気もするが、動いたとしても他のOpenWrtとの連携はできないし、追い込むモチベーションが減退して終了。
  • 最後のオプションはWDSである。設定ファイルにはWDSと思しき項目があり、いけるか?と思ったが、設定してもリンクが成立せず。こちらも撤退。

雑記雑感

  • 多くの設定や挙動がドライバ側や独自実装OS側で定義されていて、何をするにも結構なトライアンドエラーになるので、現状では何とも使いづらい。あとCodexが結構な頻度で「なぜか設定が戻っている」みたいな報告を入れてきて、同じところをぐるぐる回らされている感じになる。ウォッチドッグなのかドライバ側の実装なのか。
  • SoCの性能が高くて6GHz帯でWi-Fi 7が吹けて3,000円以下で入手できる、というスペック上では素敵デバイスなのだが、Ethernetが2.51Gbpsなので、上流が有線だとWi-Fi 6E/7が話せるクライアントがいても速度は頭打ちになる。某社の売り文句のとおり5Gが最大速度を発揮する環境ならば本領を発揮するのだろう。
  • 常用するのなら、ターミナル5以前と同じように「DHCPを止めて、あとはツルシのまま(=オフィシャルな管理画面から触れる範囲で設定を変えて)既存LAN内に高性能な無線ブリッジAPとして投入し、標準WebUIの機能の範囲内で操作する」のが妥当な役割だと思われる。
  • 我が家では上流も宅内も1Gbpsで、Wi-Fi7を喋るクライアントデバイスはいないし、5GHz帯は空いていて十分なスループットが出ているしで、メッシュ化できないなら本機を投入する上積みは特にない。現状は単なる不自由なAPでしかないのでお蔵入り。特に「壁越し&階をまたいだ通信速度でLinksys組に負ける」ので、常用する意味がなかった。
  • kn_telnetdというベンダー管理用途と思われるコンソールがTCP/55600でWAN側でListenしていて、iptablesでアクセス許可IPを(おそらくSBが利用するセグメントに)絞っている。まあストレートに事業者側の保守用なのだと思われる。プロトコルは独自っぽくて使い方は不明。
  • モバイル不使用でWi-Fiアダプタ全てオン状態での消費電力は8W前後。まあこんなもんかという感じ。
  • 5G/LTEの切替用と思われるプロセスが常時CPUを25%喰っていて気に入らないので停止させてみたが、消費電力は減らなかった。またload averageが常時9.0を超えているのも面白くないので調べたところ、監視系のスレッドが複数動いているのが原因であることが分かったが、カーネルスレッドなので止めるのは諦めた。実害はなさそうだが。
  • CPUはまずまず高性能で4コアだが、ネットワークのデータプレーン処理の大半がCPUコア2(多分2だったと思う)に集中するaffinity設定になっていて、LANでスループット測定みたいなことをすると1コア律速になって頭打ちする。手動でaffinityを分散させれば一応改善する。敢えて1コア集中になっている理由は分からないが、本来の目的であるWANの5Gが全速全開になったときにWi-Fiも含めて処理を分散できるように、なのだろう。知らんけども。
  • WebUI上の設定初期化ボタンまたは本体底面のハードリセットボタンでデバイスを初期化できることになっている。しかしこれらを実行しても、ネットワーク設定周りしかロールバックされない。少々探したところ、"/sbin/firstboot (-r -y)"をコマンドで実行すれば/overlay/upperの多くが戻ることが分かった(それでも/dataの下あたりは残存するので完全な初期化とは言えないが)。今のところ、完全に工場出荷状態に戻す手段は見つけられていない。要注意点である。


今回はこれまで。ベンダーは(欠けてない)ソースコードを公開してほしいです。では皆さんよいOpenWrtライフを。

EPGStation × n8n × Gemini でAI録画コンシェルジュを組んでみた

昨今の生成AIとワークフローオートメーションを使って、もう10年以上ガチ安定で稼働している自宅のEPGStationの録画サーバーに「AIがオススメする録画候補番組リスト」という新機軸を追加する試み。構想30分、構築一週間くらいの作業記録です。

今回はひとまず全て無償の枠内で動かすことを前提に。APIの無償枠が安定して使えるのはおそらくGeminiだけなので、Geminiで組みました。

成果物

Geminiがオススメ番組を選んでリストアップしてくれるWebページ。

  • 過去の録画実績と、個別にプロンプトで指示した条件を元に、Geminiが私と家族の視聴傾向を判断して放送リストの中からオススメ番組を拾ってくる
  • リストには予約ボタンがついていて、直接EPGStationに予約登録ができる。予約済みの番組はグレーアウトする
  • リストは一日に二度、朝と晩に更新される
  • 長すぎてもアレなので、現状では提案件数は最大30件までに制限

サンプルのn8nワークフロー

そのままでは動かないだろうが参考までに。n8nにインポートすれば手軽に雰囲気は分かると思う。各ノードの設定やJavaScriptについてはこちらを参照していただきたい。実際に動かすにはData Tableの作成や環境変数の設定、Gemini API連携の設定などの作業が必要。環境固有の情報はダミーに入れ替えてある。

AI推奨番組ダッシュボード試作品.json 

自宅のLAN内でのみ使う前提なので、CORSを全開で許可していたりなどセキュリティ的には甘い作りになっている点には注意していただきたい。またコードは全てGeminiに書いてもらっているのでコメントや注釈は一貫性に欠けているかもしれない

使ってみた感想

  • リストに上がってくる番組は「惜しい」ものが多く、実際に予約に至るのは一回の提案に一番組あるかないかで打率は低い。しかし自分で手検索するよりは効率はずっと高く、母集団のフィルタリングとしては十分に効果的。プロンプトの改良や学習方法の変更で良くなる可能性が高いので、またトライしたい
  • 推奨理由が面白い。たまに、自力では到達しないであろう番組を引っ張ってくるのも味わい深い
  • 毎日推薦された番組リストを見てるだけでも結構楽しめるので、良しとする

では、ここからは構築について。

前提となる環境

  • EPGStationでの録画システムが既に稼働中であること
  • そのホストであるLinuxサーバーが稼働していること(WindowsでもOK)
  • Dockerが動かせること

筆者のスペック

  • Linuxの一通りの操作ができてEPGStationを動かせる程度のスキル
  • コードは全く書けない。簡単なシェルスクリプトがギリ
  • n8n、というかワークフローオートメーション系を触るのはこれが初めて

やりたいこと

  • 自分が興味を持ちそうな番組の候補をAIに探させて提案してもらう
  • 提案リスト内から直接録画予約ができる(EPGStationに戻らなくていい)
  • 定期的に勝手に動いて提案してくる

作業の進め方

上記の構想と成果物のイメージをGeminiに示して、EPGStationとn8nを使いたいと伝えたら、あとはひたすらGeminiと会話して指示に従って組んでいく。マンツーマンの講師がついたワークショップみたいな感じ。n8nをどう使い始めるのか?から教えてくれるし、JavaScriptも秒で書いてくれる。はっきり言って信じられない。なんつー世の中だ。。ただしこの講師は当然ながら色々と間違えるので、付き合い方を学ぶ必要がある。初めて本格的にAI対話型で組んでみた感想はこのエントリの後半に。

実際の構築手順

  1. Ubuntu上にDockerでn8nを導入する
    導入手順はGeminiが教えてくれる

  2. Dockerのdocker-compose.ymlにn8n用の環境変数とアクセス許可を設定する。太字の部分
    ==================
    version: '3.8'
    services:
      n8n:
        image: n8nio/n8n:latest
        container_name: n8n
        restart: unless-stopped
        ports:
          - "5678:5678"
        volumes:
          - ~/n8n_data:/home/node/.n8n
          - ~/n8n_data/tmp:/tmp
        environment:
          - N8N_SECURE_COOKIE=false
          - GENERIC_TIMEZONE=Asia/Tokyo
          - TZ=Asia/Tokyo
          - N8N_RESTRICT_FILE_ACCESS=false
          - N8N_RESTRICT_FILE_ACCESS_TO=/tmp
          - EPGSTATION_URL=http://[EPGStationのホスト名またはIPアドレス]:8888
          - N8N_WEBHOOK_BASE_URL=http://[n8nのWebhook用ホスト名またはIPアドレス]:5678
          - N8N_BLOCK_ENV_ACCESS_IN_NODE=false

  3. Google AI StudioでGemini APIを有効にする
    この手順もGeminiが教えてくれる

  4. n8n上にData Tableを作成する
    ai_cacheという名前で作る。keyはlatestのみ。こんな感じになる

  5. n8n上にノードを配置していく

ワークフロー構成

全体像はこんな感じ。

処理のざっくりした流れはこう。

  1. EPGStationから、向こう2日間の番組表、予約済み番組リスト、録画済み番組リスト、の3種類のデータをAPI経由で取得する
  2. 取得したデータを合流させて整形し、余計な情報を削ってデータ量を絞る
  3. 絞ったデータにプロンプトを添えてGeminiに食わせる
  4. Geminiから出てきたオススメ番組リストをn8nのData Storeに保管する
  5. リストが更新された旨をメールで利用者に通知する
  6. 利用者がWebブラウザでオススメ番組リストにアクセスする
  7. n8nがData Storeから番組データを読んでHTMLを生成してブラウザに返す
  8. 録画したい番組の予約ボタンを押すとEPGStationにPOSTが飛んで予約が実行される

各フェーズとノードごとにもう少々細かい説明をする。

1. データ収集・前処理フェーズ(定期実行)

まず最初にEPGStationからAIの判断材料となる生データを収集する。

  • Schedule Trigger
    n8nのワークフローは、起動タイミングを規定するTriggerタイプのノードから開始するルールになっている。今回は毎日 07:15 と 18:15 の2回、ワークフローを自動で走らせることとした。一日の間に頻繁にオススメリストを更新してもあまり自分には意味がないので、朝晩の2回更新で良しとする。
  • HTTP Request (schedules)
    予約候補となる番組リストの母集団をEPGStationからSwagger APIで取得する。EPGStationは向こう一週間の全チャネルの番組表を持っているが、これを全部取得すると相当なデータ量になってしまい、後ほど後段でGeminiに投げる情報量が多過ぎてトークン上限をオーバーするので、この段階である程度範囲を絞る必要がある。まず、私はCSはほぼ見ないので、取得対象は地デジとBSのみとした。さらに対象レンジはタスク実行時から1日先~3日先の2日間とした。さらに放送局を絞って、代わりに期間を延ばすなどのアレンジをここで行うことも可能だが、それは後段で実施することとして、一旦これで行く。
  • HTTP Request (recorded)
    EPGStationですでに録画済みの番組リストを取得する。すでに録画された番組は利用者の視聴傾向を反映しているはずなので、このリストを後ほどGeminiがユーザーの好みを分析するための材料として利用する。
  • HTTP Request (reserves)
    EPGStationで現在すでに予約登録されている番組リストを取得する。すでに予約済みである番組がGeminiから重複推薦されないように、除外リストとして使用する。
  • Merge
    上記3つのAPIから取得した異なるデータを一つの流れに統合し、以降の処理を一本にまとめられるように整形する。
  • Trim (Codeノード)
    取得した生データから必要な項目(タイトル、概要、IDなど)のみを抽出し、既に予約済みの番組を候補から除外するなどの整理を行う。
  • Aggregate
    分散しているデータアイテムを一つにまとめ、次の「絞り込み」工程に渡せる形式に整形する。n8nはアイテムの単位で処理を実行するので、ここでまとめておかないと後段でGeminiにバラバラのリクエストが複数回に分かれて投げられることになり、期待する回答が得られなくなる。
    ※考えてみると前段のTrim内でも同じ処理を実行できるので、このノードは削れるかもしれない

2. AI向け最適化・推論フェーズ

AIが効率よく正確に判断できるようにデータを加工し、さらにデータ量を絞り、その上でプロンプトとして投入する。本システムのキモとなる部分。

  • Slim for Gemini (Codeノード)
    前段で放送種別や時間帯を絞って番組表を取得したが、それでもなお生の番組リストは情報量が多く、絶対に録画対象にならない番組や、AIの処理には不要なデータが大量に含まれているので、ここでそれらを除外する。放送局名、キーワードリスト、放送時間(10分以下)での除外を併用してフィルタリングする。関東地方での地デジとBSでは2日間で概ね2000件程度の番組が放送されるが、このノードでこれを約700件程度まで絞り込む。さらにAI処理およびその後段で必要になる情報(タイトル、概要、ID、開始時刻)以外をカットし、Geminiに渡すデータ量を減らす。

  • Prompt (Codeノード)

    Geminiに対してのプロンプトを書くノード。プロンプトは後段のGeminiノード内に書いても構わないのだが、流れで作業していたらここで書く作りになった。プロンプトに含めるべき要素は大きく3つある。

    • まずは「選定の基準と指針」。利用者の関心があるもの、逆に興味がないもの、優先度を上げて/下げてほしいもの、などの指示をキーワードや文章でAIに伝える

    • 次に「出力形式」。後段で正しく処理ができるように、データの出力形式をシンプルかつ明確に指定する。ちゃんと定義しておかないと出力の揺れが発生して処理がエラーになったり、推奨データがおかしなことになったりする。特に各番組の一意の識別子となるProgramIDは確実にキープするよう指示する
    • 最後に「抽出用の元データ」。前段で整形した番組表と、嗜好判断用の録画済み番組リストを渡す

      プロンプト自体はこのエントリのもう少し先に記載した。

3. 保存・通知フェーズ

Geminiの出力した推奨リストをローカルストレージに保存し、ユーザーに更新完了を通知する。

  • Upsert row(s)
    Geminiが選んだ推薦番組リストと、詳細情報を含むマスターリストを、n8n内部のデータテーブル(ai_cache)に保存する。データテーブルは直近のGeminiの出力結果だけを保持する超シンプルな作り。ワークフローが走るたびに毎回更新され、最新の結果で常に上書きされる。過去の情報は持たない

  • Send email
    ダッシュボードの更新をメールで通知する。ユーザーは自分と家族しかいないし、日に二度実行されることは分かっているので必須ではないし、処理が失敗したときにだけエラー通知すれば用は足りるのだが、しかし正常に稼働してますよというプッシュ型通知の意味と、あと通知が届くとなんとなく嬉しいので賑やかしとして付けた。

4. ユーザーインターフェース(ダッシュボード)表示フェーズ

ユーザーがブラウザで推薦結果を確認して予約操作を行うためのWebページを生成するプロセス。独立したサブワークフローとして設置する。このフローをメインのフローに結合してしまうと、ページを開くたびにGeminiが走って処理が非常に重くなる上に、早々にトークン超過で利用不可になってしまうので、ダッシュボードを表示するだけの別プロセスとして切り離す。

  • Webhook-dashboard
    Webサーバーの口としてHTTPリクエストを待ち受ける。リクエストを受けて以降のワークフローをキックする

  • Get row(s)
    データテーブルから最新のAI推薦データを読み込む
  • HTTP Request (reserves)2
    ダッシュボードを表示する瞬間の最新の予約状況をEPGStationから取得する

  • Prepare Webhook URL
    環境変数からWebhook用のURLを取得して後段のCodeノードにwebhook_urlとして渡す。n8nではCodeノードでJavaScriptから直接環境変数を読めない(とGeminiが言っていた)ので、このノードを追加する流れになった
  • Dashboard (Codeノード)
    読み込んだデータをHTML/JavaScriptに変換し、番組名、推奨理由、「予約ボタン」が並ぶWeb画面のデザインを生成する

  • Respond to Webhook
    ブラウザに対して、完成したHTMLダッシュボード画面を返送する

5. 予約実行フェーズ

ダッシュボード上の予約ボタン押下を受けて実際にEPGStationに録画予約を行うプロセス。

  • Webhook-reservation
    ダッシュボードの「予約する」ボタンが押された際に発行されるPOSTリクエストを待ち受ける。POSTリクエストには番組IDが含まれる

  • POST to EPGStation
    受け取った番組IDをAPI経由でEPGStationにPOSTリクエストとして送信し、録画予約を確定させる

Geminiに渡すプロンプト例

# ROLE
あなたは、私が視聴するべき番組を選定し推奨する専任コンシェルジュです。

# HOW TO THINK
- 【REFERENCE】から私の視聴傾向・好みを推定してください
- 【CANDIDATES】の中からのみ、推薦番組を選んでください
- 【REFERENCE】に含まれる番組自体を推薦してはいけません

# USER PREFERENCE (EXPLICIT)
・関心があるもの:
  旅行、日本の地方文化、美術、芸術、音楽、自然、動物、鉄道、
  ドキュメンタリー、料理、食事、日本の伝統、離島、宇宙

・関心がないもの:
  バラエティ、スポーツ中継、通販、ショッピング、釣り、自動車

・注目キーワード:
  北海道、富山、瀬戸内、山陰、孤独のグルメ、tiny desk concert

# SELECTION RULES
- 再放送(タイトルに [再] を含む番組)は優先度を下げる
- スポーツの試合中継番組は優先度を下げる
- 選定する番組のカテゴリーが極端に偏らないようにする(条件に該当する番組が少ない場合は偏っても可)
- 最大で30件まで選定(条件に該当する番組が少なければ30件未満でも可)
- あなたは、私の視聴傾向に必ずしも合致しない可能性がある番組を、最大で3件まで、あなたの判断で選んでも構いません

# OUTPUT
 - 選定した番組の ID [programId] と 番組名 [title] と 推薦理由 [reason] のみを、以下のフォーマットのJSON形式で出力してください
   [{"ID": "...", "title": "...", "reason": "..."}]
 - IDに格納するprogramIdの値は元のデータから一切変更せず、そのまま用いてください

# REFERENCE: WATCH HISTORY(嗜好推定用・参考情報)
${recordedText}

# CANDIDATES: PROGRAM GUIDE(推薦候補・ここからのみ選択)
${schedulesText}

開発アシスタントとしてのGeminiの使い勝手

  • FlashとThinkingを意図的に使い分けると効果的。全体デザインはThinkingで、個別のノード設定やシンプルなJavaScriptの作成はFlashで。Flashで何回試してもコードが修正できない場合はThinkingに切り替える。n8nはワークフローをJSONファイルとしてダウンロードできるので、行き詰ったらJSONをGeminiに食わせてThinkingモデルで全体レビューと解決方法の提案をしてもらうと突破しやすい
  • 特にFlashモデルはフロー全体のデザインや整合性を俯瞰で見るのが苦手なので、今の作業は本当に期待するゴールに向かっているか?は自分で配慮しながら進める必要がある。任せきりにすると、例えば推奨リストを見るたびに毎回Gemini APIを叩く(=アクセスの度に長時間待たされる上にトークンがすぐに上限を超える)デザインを提案してきたり、データの保管先に生のJSONファイルを使おうとしたり、何もかもGeminiへのプロンプトに投げ込もうとしたりする。「これはおかしくね?」とか「違う手段のほうがいいのでは」と思ったら迷わず指摘するのが重要
  • Geminiは比較的粘りと頑張りに欠けていて、ある意味現実的なところがあり、何度か試して上手くいかない課題があると、正面突破を諦めて別の回避策を提案してくる傾向がある。提案は妥当なこともあるが、雑で安易な逃げの手だったりもするので、採用するかどうかの判断はしっかり行う。ちなみにChatGPTは愚直に課題に挑むが解決できずにループに陥ったりする。キャラクターの違いが中々味わい深い。クールで冷静なClaudeが一番こういうのには向いている気がする
  • n8nの使い方に関しても詳しく教えてくれるが、情報が古かったりして、実際にメニュー内に存在しないオプションを設定するよう指示することが頻繁にある。その都度、実際のメニューはこうなっているが、どうすればいいか?と再質問するか、自分で適当に設定した上でJSONを食わせてチェックを依頼するといい
  • スクリプトはすぐに書いてくれるが、動かないことも多い。一発で成功すると思わず、エラーの情報を与えたり前段からのデータを添えるなどして、周辺情報を与えつつ何度か修正を繰り返して徐々に先に進んでいく。トライアンドエラーとブラッシュアップを粘り強く繰り返す。粘り強く、と言っても自分一人でやるより100倍速いので文句は全くない。しかも無償だし。あなありがたや
  • Geminiが書いたコードをChatGPTなどの別のAIに評価させるのもアリ。Geminiが書いたコードをChatGPTがコキ下ろすシーンに何度か遭遇し、結構笑えた

今後やりたい追加実装

  • 録画済み番組だけではなく、予約済み番組も傾向把握材料としてGeminiに食わせてもいいかもしれない。あんまり変わらなさそうだけど
  • Aggregateノード周辺の処理は少々冗長な気がするので見直したい
  • 傾向把握に使う録画履歴は「その時点でEPGStation上に残っている録画の最新100件」のみを都度使う作りになっている。つまり長期間の視聴傾向の蓄積はしていないし、使い込むほどGeminiのアルゴリズムが洗練されたりはしない、なので、時間経過とともに育つコンシェルジュに挑戦したい。今のGemini APIでは過去の会話の履歴を長く引き継げないはずなので、ちょっとハードルが高そうだが...

苦労したところ

  • 番組表のデータ量なんて大したことないでしょと思っていたがそんなことはなかった。当初は一週間分まるっとEPGStationから拾って全部Geminiに食わせりゃOKなどと安易に考えていたが、秒でトークン超過することが分かり、データの品質をキープしつつ量を削る手法を考えるのに結構な時間を使うことになった
  • 初期段階でGeminiの指示に安易に従った結果、推奨番組リストも含めたHTMLダッシュボード出力までの全てをGeminiに任せるフローが組み上がった。これは上手く動くこともあるが結構な確率で失敗する(Geminiからの出力がブレてHTML構造が壊れる)上にトークン量が増加するという欠点があり、路線転換するのが結構面倒であった
  • Geminiからの出力データを毎回同じ形式になるよう厳密に守らせるのが意外と大変であることが分かった。例えば、この構築の初期段階では、Geminiに推奨候補を選ばせるだけでなく、それをリスト化してHTMLページを生成するところまでを全部やらせようとしたのだが、実行のたびにタグ構造が壊れたとかJSONじゃないとかスクリプトエラーだとかバリエーション豊かなパターンでフローが失敗して使い物にならなかった。これを防ぐために、Geminiからの出力は最小限のデータ量で極力シンプルな形になるよう変更し、HTMLの生成や予約済みデータとの照合は別途切り出してJavaScriptでの実装とした。適材適所ということである
  • 同様にGeminiが長いリンクの文字列を何故か一部だけ変更してしまいリンク切れになる問題が多発したので、明示的に変更しないよう指示して概ね抑制できるようになった(それでも極稀におきるが)

その他雑感など

  • 月並みな感想だが生成AIヤバい。Web開発経験はなく、コードも書けず、ワークフローツールに触ったこともない程度の人間がちょっと作業しただけでこのくらいの仕組みを組めてしまうとは。なんつー時代だ
  • 毎度のことですがDocker様本当にありがとうございます
  • EPGStationの作者様に改めて感謝。今回ようやくAPIをフル活用できました
  • 一部のベンダーがノーコードノーコード騒ぐ理由を実感できた
  • 今回は推奨番組ダッシュボードという形式にしたが、ちょっとアレンジすればn8nが勝手にEPGStationに録画登録する形にすることも可能。しかし今のところは打率が低いので、最後は人の手で選ぶのがちょうど良さそうである
  • 少し時間が経過したら、このようなフローを組まずとも、OpenClawとかでもっと簡単な指示で勝手にニーズを満たしてくれるようになりそうな気がする


では皆さま、よい録画生活を。


Google Cloud上にUptime Kumaで監視サーバーを建ててTailScale経由でLAN内監視をするメモ

できるだけ簡単に低コストで自宅内環境の死活監視をしたい、ということで環境を組んだ際のメモです。一応自宅LAN内に普通に監視サーバーを立てれば監視はできるんですが、それだと

  • 監視サーバー自体の障害を検知できない
  • 自宅のネット回線が落ちるケースでは通知が飛ばせない

という課題があり。次にSaaS型の監視サービスの利用を検討したんですが、有償かつ機能がリッチすぎる商用サービスが大半(そりゃそうだ)で今回の目的にはちょっと合わないな、ということで、さらにシンプルな方法を探して行きついたのがこの構成です。

やりたいこと

  • 自宅のルーターとサーバの死活監視がしたい。死活監視だけでいい
  • とにかく簡便に構築したい。設定ファイル弄り回したりDB建てたりしたくない。ネットワーク周りも触りたくない。Firewallに穴開けたりするのも面倒
  • 極力低コストで運用したい

利用したサービス

やったこと

  • 自宅側のアクセスルータとしてOpenWrtを用意し、そこでTailScaleを稼働させる
  • Google Cloud上に無償利用枠内(e2-micro)のVMインスタンスをUbuntuで建てて、監視ツールのUptime Kumaをdocker composeで立ち上げる。さらにTailScaleを動かして自宅とつなぐ
  • 自宅のデバイス群はTailScale経由でUptime Kumaで監視する
  • Uptime KumaとホストのVMマシンは、Google CloudのUptime Check機能で監視する

Uptime Kumaのコンソール画面

出来るようになったこと

  • 自宅の何かしらが止まるとUptime Kumaからメールが来る。メッシュの端のルーターが落ちたとか、録画用サーバのEPGStationが止まった、とかが分かる
  • Google Cloud上のVMマシン、ないしはその上で動くUptime Kumaが止まると、Google CloudのUptime Checksから通知が来る

作ってみて

  • Google Cloudの利用費が月額14円程度発生する。完全無償とはならなかったが、駄菓子以下なので良しとする
  • 連続稼働時間が長くなると、Uptime KumaがOOM Killerで落とされることがある。毎週日曜早朝にUbuntuごと再起動することで回避した
  • 毎度のことだがTailScaleが画期的すぎる。技術的に強力なのはもちろん、ユーザーエクスペリエンスが最強すぎる。感服いたします
  • Dockerさん本当にありがとうございます。コマンド一発で監視サーバーが起動できるなんて誠にありがたやありがたや
  • Google Cloudさん、VMインスタンスの無償枠提供に感謝を申し上げます


かつてはPrometheusでGrafanaに連携して地球防衛軍みたいな派手なダッシュボードでテレメトリーやらメトリクスを一括可視化でどうのこうの、みたいなこともしたけれど、もはや自宅システムの監視にそこまで手間をかける元気はなく。こういうのでいいんだよ、こういうので、的な実用性重視の自宅監視をしたい方はご参考になさってください。


では良い監視ライフを。


OpenWrtを使ってWi-Fi中継器(エクステンダー)を構築する

OpenWrtでのWi-Fiエクステンダー構築については、本家に構築ドキュメントが公開されていて、こちらに沿うのが確実な方法です。当記事は、これを参考にしつつ自分の構築用にメモを残したものです。

序文

先日、嫁さんがしばらく実家からリモートワークをすることになったのだけど、仕事をする部屋が離れにあってWi-Fiルータの電波が十分に届かないらしい。終日スマホのテザリングをすると帯域制限に引っ掛かりそうということで、OpenWrtを中継器に仕立てて、電波の届く距離を延ばして対処することにした。

上流の親ルーターは10年以上前の802・11bgnのみ対応の古いバッファロー製のやつで、速度もおそらく出ないのだが、今回は既存の環境には変更を入れたくないので、上流はそのまま使うことにする。

Wi-Fiブリッジをどう組むか?

一台のOpenWrt上にWi-Fiクライアントとアクセスポイントをそれぞれ作成して、両者間で透過的にネットワークブリッジを成立させる方法は(おそらく)3パターンある。

  1. WDS(Wireless Distribution System)を使う
  2. メッシュ(802.11s)を組む
  3. Relay Bridgeを作成して必要なデバイスを連結する

1は最も簡単な方法だが、親ルータがWDSに対応している必要があり、今回はその可能性は皆無なので却下。2も当然ながら親ルータがメッシュ非対応なので不採用。従って3のRelay Bridgeで組むことにする。

注意点として(OpenWrtでの)Relay bridgeはIPv6の透過に制限があるらしく、IPv6環境では色々と手を入れないと上手く動かないらしい。幸い今回はIPv4環境なのでこの制限は該当しない。

ネットワーク構成

今回の要件

  • 親ルーターの下にOpenWrtをWi-Fiエクステンダー(L2透過ブリッジ)としてブラ下げて、2.4GHzで受けて5GHzで中継する
  • Wi-Fiクライアントが親ルーターから直接DHCPでIPアドレスを取れる
  • 有線/無線クライアントからluci/SSHにアクセスできる
  • OpenWrt自体がインターネットに出られる
  • tailscale経由で遠隔地からluci/SSHにアクセスできる(保守用)

使うハードとソフト

  • Cisco Meraki MR42(手持ち機材の中で送受信性能がベスト)
  • OpenWrt 24.10(23系でも同じだが)

構築手順

  1. OpenWrtの2.4GHzアダプタ上に、親機に接続するためのwirelessクライアントを設定し、親機に接続できることを確認する

  2. 上流用のネットワークインターフェースを新規作成する。名前は何でもいいが、ここではwwanとする。プロトコルはDHCPとし、use default gatewayにチェックが入っていることを確認する。手順1で作成したクライアントが使用する物理アダプタをデバイスとしてwwanに紐づける。設定したら一旦wwanをrestartし、親機からDHCPでIPアドレスを受け取れていることを確認する

  3. 手順1で作成したwirelessクライアントのネットワークにwwanを紐づける

  4. Firewallのゾーン設定で、lanゾーンにwwanを紐づける

  5. OpenWrt自体がインターネットに出られることを確認する。Ping等で適当に

  6. Relay bridge用の追加パッケージをインストールする。
    # opkg update && opkg install relayd luci-proto-relay

  7. OpenWrtの5GHzアダプタ上に、クライアントデバイス向けのアクセスポイントを設定する。ネットワークにはlanを紐づける

  8. lanインターフェースのuse default gatewayが外れていることを確認する

  9. lanインターフェースのIPアドレスを、親機と同じセグメント内でありなおかつDHCPの割り当てレンジ外のものに変更する。必要に応じて、このセットアップを行っているクライアントデバイスのIPも変更する(しないと接続できなくなる)。ここでlanに割り振ったIPアドレスがOpenWrt本体へのアクセス用アドレスになる

  10. OpenWrt上にRelay Bridgeインターフェースを作成する。名前は何でもいいが、ここではrelaydとする。作成したrelaydにwwanとlanを紐づける。relaydにはIPアドレスは割り当てず空欄とする

  11. 手順7で作成したアクセスポイントにクライアントPCを接続し、以下を確認する
    • 5GHzのアクセスポイントにWi-Fi接続ができる
    • DHCPでIPアドレスが取得できる
    • インターネットへ疎通ができる
    • OpenWrtのSSHおよびluciに接続ができる

  12. ここまで成功すればブリッジとしての設定はOK。続けてtailscaleをインストールし、tailscaleネットワークに接続ができ、別のtailscaleクライアントからOpenWrtのSSH/luciにアクセスができることを確認する

上記の通りインターフェースを設定すると、luci上ではこのように見える。

以上お疲れさまでした。

構築時の注意点

  • OpenWrt本体がインターネットに出るために、wwanのみでuse default gatewayを有効にする。それ以外のインターフェースでは全て無効にする
  • DHCPは親機のみとし、OpenWrtの全てのインターフェース上でDHCPサーバを無効ないしは停止に設定しておく。dnsmasq自体をdisableにしておいてもいい

メモと雑記

  • relaydはL3での疑似ブリッジであり、ブリッジの前後でL2(MAC)セグメントが分割されてしまうため、OpenWrt自体をインターネットにアクセスさせつつ同時にクライアントからluciを開けるようにする、という条件を満たそうとすると設定が若干トリッキーになる。今回はその解決のために、lanとwwanにそれぞれ同一セグメントの異なるIPアドレスを割り当てる形とした
  • WDSや802.11sのメッシュはL2での透過的アクセスができるので、使えるのであればこれらがベター。relaydを積極的に使う理由はない
  • 考えてみると、親機とローミングを組むわけではないし、同一ネットワーク内の別デバイスと相互通信するニーズもないので、ブリッジにこだわらずシンプルに二重ルータ方式で構築したほうが早かった気がする(苦笑)


以上。皆さんよいOpenWrtライフを。


FortiWifi 50E-2RにOpenWrtを導入したメモ

安価に売られているネットワークデバイスをなんとなく買ってOpenWrtを入れて棚にしまうだけのシリーズ、今回はFortinet社のFortiWiFi 50E-2R。

FortiGate 50EとFortiWifi 50E-2Rの違い

名前の通り、2RにはWi-Fiが搭載されていることがおそらく唯一の違い。他は完全に同じと言っていい。Wi-Fiデバイスが追加されたためか、電源の要求スペックが50Eの2Aに対して50E-2Rは2.5Aに上がっている。実際の消費電力が2Aを超えるシーンは、ご家庭での利用上ではあまり発生しそうにないが。

OpenWrt導入手順

これも50Eと一緒。musashino先生のサイトの手順に従うのみ。ただし一点だけ事前準備でinitramfsイメージの名前を変える必要があり、その方法はこちらのサイトに掲載されている。毎度ながら先達の知恵に感謝。

Wi-Fi周りの実装

マザーボードの表と裏にmini pcieスロットが一つずつ実装されていて、それぞれにGmtekというメーカーのAtheros QCA9880のカードが刺さっている。

OpenWrt上ではこのように見える。

Fortinet 50E-2RでのWifiアダプタの状態

どちらのカードでも5GHzと2.4GHzの全ての周波数帯を利用できるが、カード1枚につきアダプタも1系統となる。カード1枚に対して5GHzと2.4GHzのアクセスポイントを2つ作成して同時に異なる周波数帯で稼働させることはできない。

また、OpenWrtから見える1枚目のカード(マザボ裏側)では、5GHzは普通に使えるが、2.4GHzの性能は送受信性能が著しく低く、ほぼ使い物にならない。2枚目(表側)は逆で、2.4GHzは問題ないが5GHzが使えない。2枚のカードは完全に同一型番なので、おそらくマザーボード上のアンテナ線のどこかで減衰をかけているのだと思われる。従って結局のところは普通に5GHzと2.4GHzを1系統ずつ積んだルーターとして利用することになる。

しかしこれだと何だか面白くないので、アンテナケーブルを別途用意して無線カードに直結してみたところ、やはりどちらのカードでも2.4Ghz/5GHzともに普通に動くようになった。マザボ上で減衰されているのはほぼ確実と言って良さそうである。ただしアンテナは2本しかないので、2枚のカードでアンテナを共用して両方5GHzを喋らせると同時通信時に通信速度が著しく下がる(当たり前)。なので実用性はあまりない。もう一系統アンテナを別に用意してやれば同時にフルで5GHz稼働できるが、そこまでやる意味があるのかかなり微妙である。

またコネクタの種別がややこしいので、ケーブル線の購入にあたっては間違えないようにしたい。本機にデフォ搭載されているカードに適合するのはU.FLとかIPX(の1.13mm)とか言われるコネクタである。私はAliexpressのTUOLINKで調達した。

二股分岐の同軸ケーブル。これは間違えて買ったほう(苦笑)

私のゲットした個体は純正アンテナが欠品していたので(おかげで安価だった)自宅に転がっていたTP-Link C7用のアンテナを適当に装着した。この状態での送受信性能は、Baffaloのエントリーグレードの家庭用ルータ並み。NetgearやLinksysのルータと比べると劣る。自宅の同一フロア内であれば普通に使えるが、階を隔てるとちょっと厳しい。まあ50E-2RのWi-Fiの利用目的は中小企業オフィスでの無線LANセキュリティの向上であって、例えばおかしなアクセスポイントが周辺にないかスキャンして監視する、みたいな用途のために使うものらしく、通常の無線アクセスポイントとしてゴリゴリ使う想定ではないのだろうから納得はできる。

SSDは動くのか?

動かないだろうなあと思いつつ、宅内に転がっていたmsataのssdをmini pcieスロットに刺してみたが、やはり認識されなかった。msata兼用スロットではないようである。片系のwifiカードをssdに交換できれば、overlayが小さい問題を解決しつつ無線も使えてバランスのいいデバイスになるのだが、残念。

メッシュに組み込む際のひと手間

このデバイスのAtheros QCA9880は、OpenWrtにデフォルトで入っている"-ct"ドライバだと802.11sのメッシュが動かない。メッシュアクセスポイントとして動かす場合は、ctナシの無印ドライバに入れ替えること。opkg list-installed | grep ath10kで探して、ct付きのドライバとファームウェアの2種類を変更する。

余談

マザーボードの隅っこには「FG-51E」とシルク印刷されている。51EはSSD搭載モデルのはずだが、基盤は共通なのだろうか。

所感など

  • Wi-Fiを搭載しているので、50Eと比べれば遊べる度合いは上がるが、MIMO2x2だし、アクセスポイントとしての性能は家庭用ルータと変わらないので微妙。50Eと同じ価格で出ていたらこっちを選んでもいいかも、くらい。

  • その他は須らく50Eといっしょ。やっぱりoverlayがもう少し欲しい。Fortiの純正ファームに戻す予定はないので、バックアップのファーム領域をツブしてoverlayに利用したいところだが、そうするには自分でOpenWrtにしかるべき変更を加えてビルドする必要がある。トライする気力がないのでextrootでお茶を濁すことにする。→ 先人の知恵を借りて自前ビルドをやってみた。確かに100MB超のoverlayを確保できてブラボーなのだが、やっぱりビルドには時間がかかるので頻繁にやるのはダルい。一度稼働させたらしばらくはバージョンアップしたくない感じ。結局USBメモリでのextrootに戻るかも。。

  • Realtekの8822CEカードが自宅に転がっていたので目的もなく交換してみて、普通に動いたが、送信出力がさらに低くなったこと以外には違いはなかった(当たり前)。クライアント用のカードだしな。。。OpenWrtで安定して動くmini pcieのWi-Fi 6の拡張カードが出てきたら、いずれ試してみたい。ちなみにIntelのWi-Fi 6のカードは入手性がよく安価だが、APモードでは動かないらしい。残念。


では皆さん良いOpenWrtライフを。